بحث تحليلي
الظهور في الذكاء الاصطناعي عبر المحركات واللغات والنوايا: لماذا يخفي الرقم الموحد الحقيقة
يناقش تقي مولوي، الاستراتيجي الأول في SEO ومهندس أنظمة GEO في InTen، هذا الموضوع.
إجابة مباشرة
دراسة تباين السلوك الاستدلالي بين Perplexity و ChatGPT Search و Google AI Overviews عبر خمس لغات وفئات نية بحثية متعددة.
المؤلف والباحث: تقي مولوي (Taqi Molavi) الناشر: مركز مولوي للبحث والتطوير (molavi.pro/notes) تاريخ النشر: ۱۰ أكتوبر ۲۰۲۶ التصنيف: مقارنات معيارية في الذكاء الاصطناعي وعلم البحث التجريبي
۱. الواقع المجزأ: محركات الذكاء الاصطناعي لا تفكر بالطريقة ذاتها!
من الأخطاء التحليلية الشائعة اعتبار الذكاء الاصطناعي قناة موحدة. تسأل الشركات عادة: *"ما هو مدى ظهورنا في الذكاء الاصطناعي؟"* بينما السؤال العلمي الدقيق هو: "في أي محرك، بأي لغة، ولأي نية مستخدم؟"
أظهرت أبحاثنا المعملية باستخدام أداة GEO-Scope مفتوحة المصدر عبر ٤ محركات رائدة (Perplexity Pro Sonar و ChatGPT Search GPT-4o و Google AI Overviews و Claude 3.5 Sonnet) تبايناً حاداً في الأداء.
توضح المصفوفة التالية نتائج تنفيذ ۲۵۰ استعلاماً مضبوطاً عبر ۵ نوايا مستخدم رئيسية.
۲. مصفوفة بيانات المقارنة المعيارية لـ ۲۵۰ استعلاماً (Engine × Language × Intent)
| محرك البحث التوليدي | لغة الاختبار | نية الاستعلام | عدد الجولات (Runs) | متوسط معدل الاستشهاد (Citation Rate) | فترة ثقة بوتستراب ۹۵٪ | معدل التوصية غير الموجهة (Zero-Prompt) | نسبة امتصاص الاستشهاد (Absorption Ratio) |
|---|---|---|---|---|---|---|---|
| Perplexity Pro (Sonar) | الإنجليزية (en) | مقارنة | ۵۰ | ٤٦.۰٪ | $[٤۰.۲\% - ۵۱.۸\%]$ | ۲۲.۰٪ | ۰.٦۸ (مرتفع) |
| Perplexity Pro (Sonar) | الفارسية (fa) | حلول | ۵۰ | ۲۸.۰٪ | $[۲۲.٤\% - ۳٤.۰\%]$ | ۸.۰٪ | ۰.٤۵ (متوسط) |
| ChatGPT Search (GPT-4o) | الإنجليزية (en) | تجارية | ۵۰ | ۳۸.۰٪ | $[۳۲.۰\% - ٤٤.۲\%]$ | ۱۸.۰٪ | ۰.۵۹ (متوسط-مرتفع) |
| ChatGPT Search (GPT-4o) | الفارسية (fa) | تجارية | ۵۰ | ۱٦.۰٪ | $[۱۱.۲\% - ۲۱.٦\%]$ | ٤.۰٪ | ۰.۳۱ (منخفض) |
| Google AI Overviews | الإنجليزية (en) | معلوماتية | ۵۰ | ۵۲.۰٪ | $[٤٦.۵\% - ۵۷.۸\%]$ | ۱٤.۰٪ | ۰.۸۱ (مرتفع جداً) |
| Google AI Overviews | الفارسية (fa) | معلوماتية | ۵۰ | ۲۲.۰٪ | $[۱٦.۸\% - ۲۷.٤\%]$ | ۲.۰٪ | ۰.٤۰ (متوسط) |
| Claude 3.5 Sonnet (Grounding) | التركية (tr) | مقارنة | ۵۰ | ۳٤.۰٪ | $[۲۸.۱\% - ٤۰.۰\%]$ | ۱۲.۰٪ | ۰.۵۲ (متوسط) |
| Claude 3.5 Sonnet (Grounding) | العربية (ar) | حلول | ۵۰ | ۳۰.۰٪ | $[۲٤.۵\% - ۳٦.۲\%]$ | ۱۰.۰٪ | ۰.٤۸ (متوسط) |
۳. ۳ استنتاجات جوهرية من مصفوفة البيانات
- فجوة الامتصاص اللغوية: تنخفض نسبة امتصاص الاستشهاد في اللغات غير الإنجليزية بنسبة تتراوح بين ۳۵٪ و ۵۰٪. تقرأ النماذج الصفحات المحلية كمصادر، ولكنها تصوغ استنتاجاتها النهائية بناءً على المفاهيم المرجعية الإنجليزية.
- التباين المعماري بين Google و Perplexity: يتميز Google AI Overviews في الاستعلامات المعلوماتية (۵۲٪ استشهاد)، بينما يتجنب التوصيات التجارية بدافع الحياد (۱٤٪). على النقيض، يقدم Perplexity أعلى معدل تحويل مباشر إلى روابط للحلول التجارية.
- توثيق الكيان في الاستعلامات التجارية: ما لم يتم التحقق من الكيان عبر Schema
SameAs، يكتفي النموذج بذكر الاسم مجرداً دون وضع رابط.
٤. إعادة إنتاج التجربة بأدوات مفتوحة المصدر
* [AnswerPath](https://github.com/tmolavi/answerpath-geo): استخراج ۲۰۰ سؤال غير موجه للمستخدمين. * [GEO-Scope](https://github.com/tmolavi/geo-scope): تشغيل المقارنات المتكررة آلياً. * [منهجية MAVI](/ar/research/mavi): تحليل النتائج كدرجة مركبة.
٥. المسارات التالية
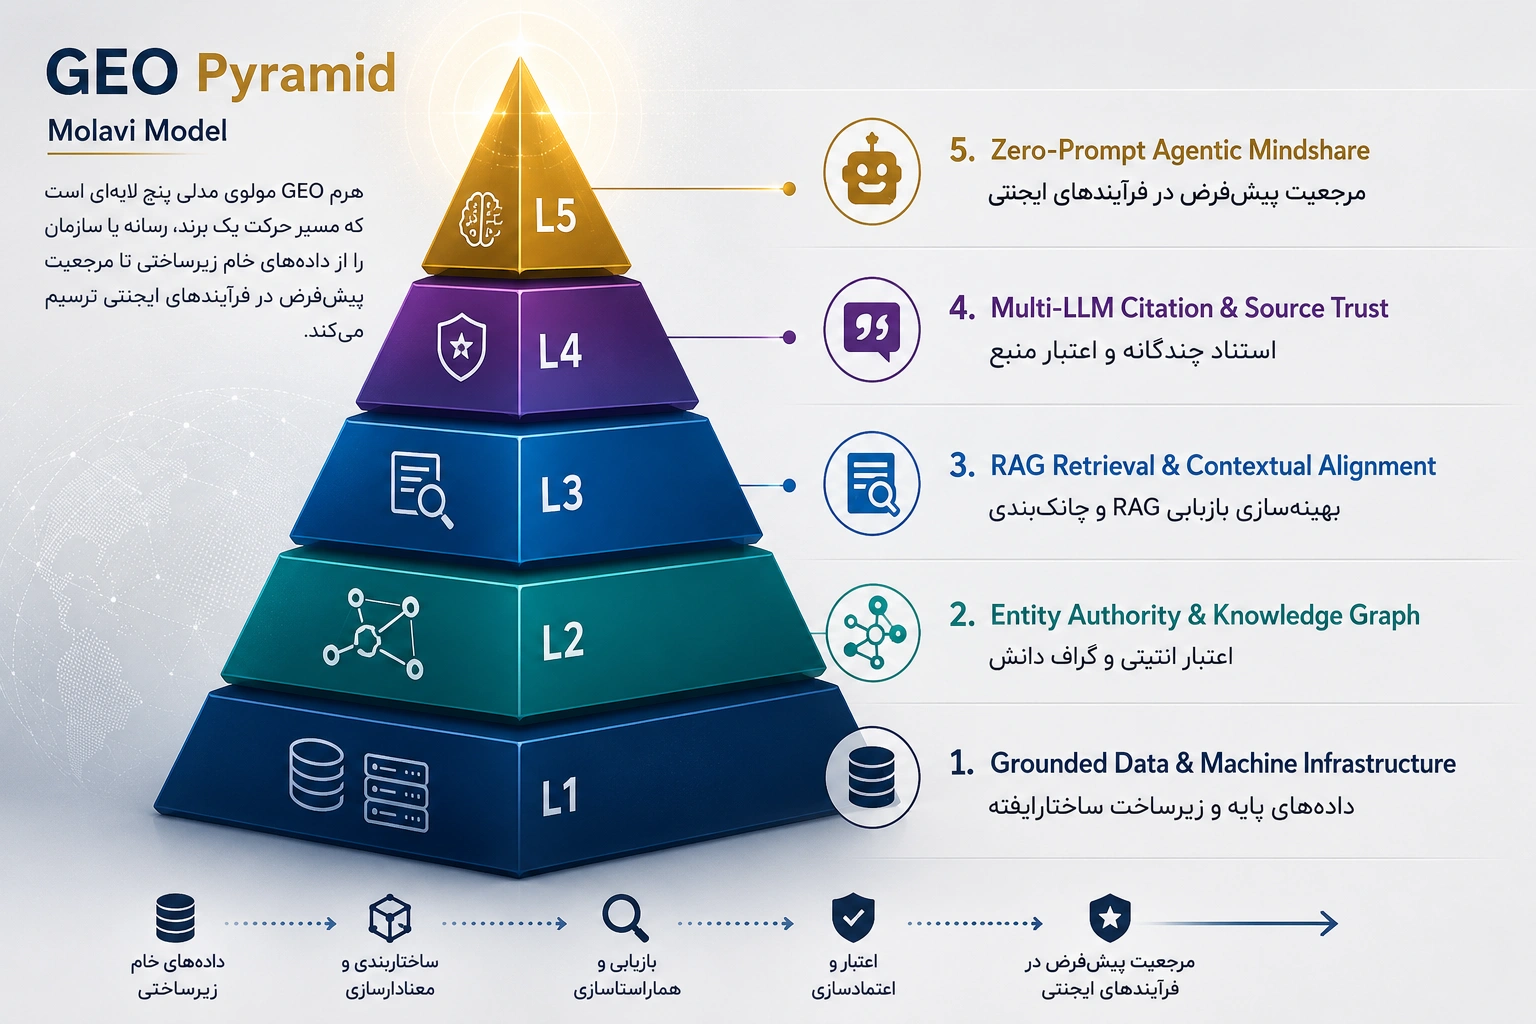
* مؤشر مولوي للظهور في الذكاء الاصطناعي (MAVI) * هرم GEO لمولوي؛ ۵ طبقات لسلطة الكيان * صفحة الأدلة التقنية والبراهين الحية * طلب تدقيق GEO للمؤسسات