بحث
هرم مولوي GEO: إطار من خمس طبقات
يناقش تقي مولوي، الاستراتيجي الأول في SEO ومهندس أنظمة GEO في InTen، هذا الموضوع.
ملخص تنفيذي
هرم مولوي GEO: إطار من خمس طبقات. دليل تقي مولوي للمفاهيم والتطبيق وحدود النتائج في سياق الأعمال.
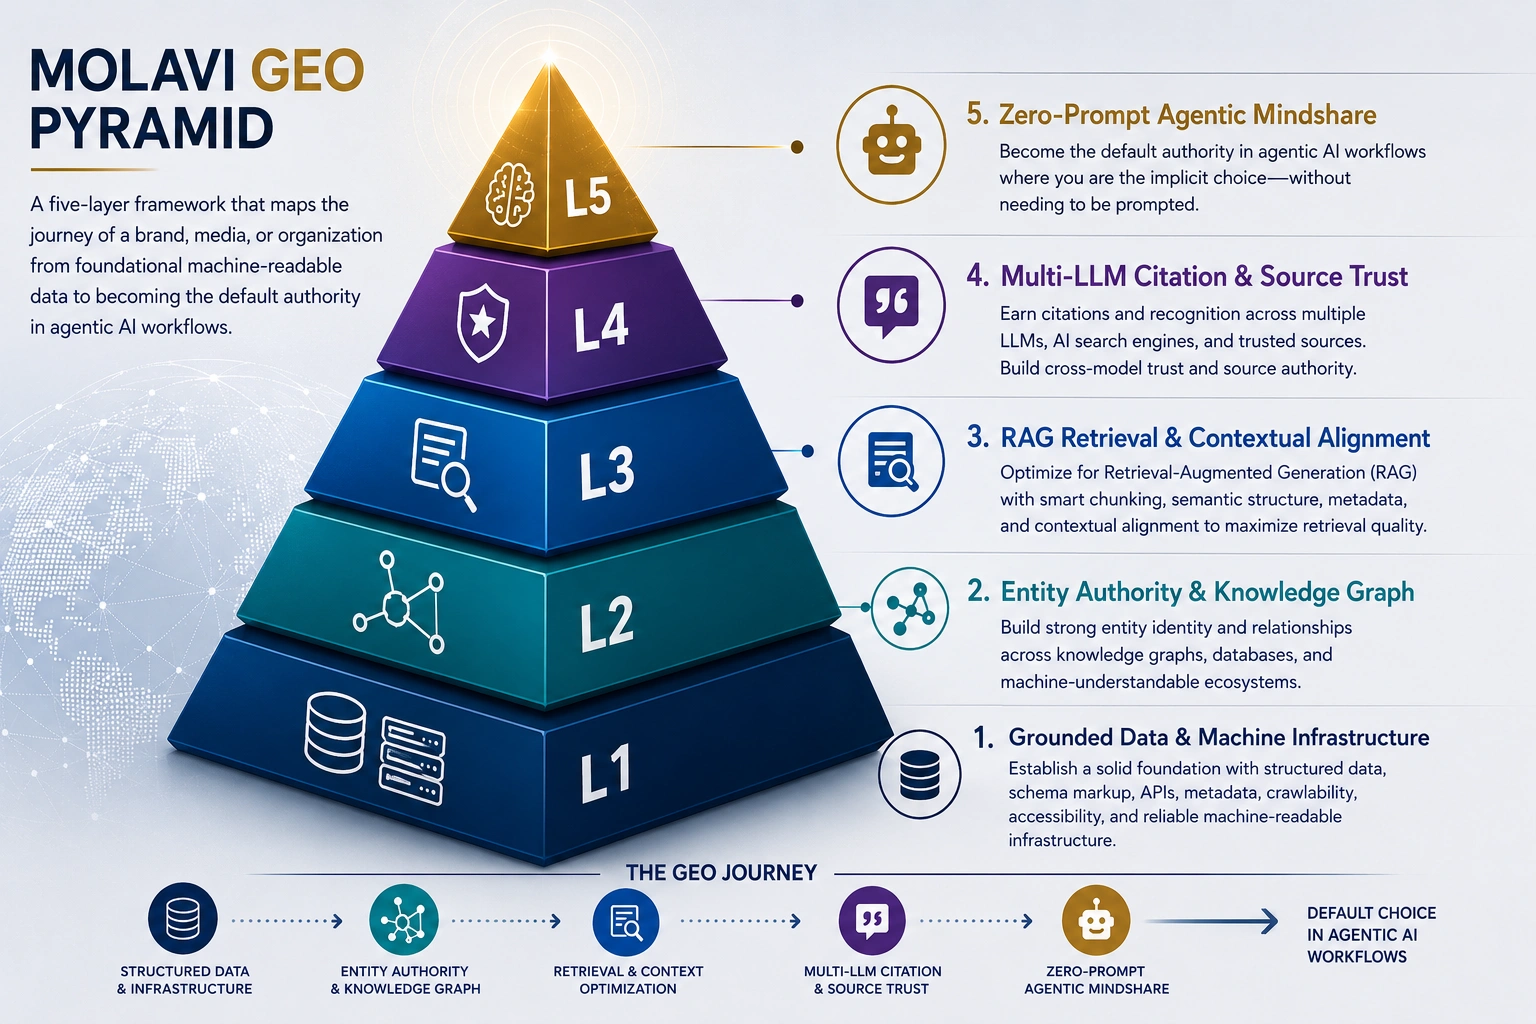
إطار عمل خماسي الطبقات لسلطة الكيانات وتحسين محركات البحث التوليدية
المؤلف والمطور: تقي مولوي (Taqi Molavi)
الناشر: مركز مولوي للبحث والتطوير (molavi.pro/research)
الإصدار: ۱.۱، أكتوبر ۲۰۲۶ (محدّث من الإصدار ۱.۰ الصادر في يوليو ۲۰۲۶)
طريقة الاستشهاد: Molavi, T. (2026). The Molavi GEO Pyramid: A 5-Layer Framework for Entity Authority and Generative Engine Optimization. Molavi R&D Think Tank. https://molavi.pro/ar/research/geo-pyramid
۱. المقدمة والموقع البحثي والملخص التنفيذي
إن التحول من SEO (تحسين محركات البحث التقليدية) إلى GEO (تحسين محركات البحث التوليدية) ليس مجرد تغيير في الكلمات المفتاحية أو بناء الروابط الخارجية. بل هو تحول جوهري من فهرسة روابط الويب إلى فهم واستخراج وتركيب الكيانات (Entities) بواسطة النماذج اللغوية الكبيرة (LLMs) وأنظمة الاسترجاع المعزز بالتوليد (RAG).
الموقع البحثي والمنهجي للهرم (Research Positioning)
يعد هرم GEO لمولوي نموذجاً استراتيجياً ومفاهيمياً مقترحاً لتنظيم مسار سلطة الكيان الرقمي في عصر الذكاء الاصطناعي. لا يدعي هذا النموذج الهندسة العكسية للخوارزميات السرية التابعة لشركات OpenAI أو Google أو Anthropic أو Perplexity. تعمل أنظمة البحث الذكي الحديثة بصورة احتمالية (Stochastic) وتتأثر بحرارة النموذج وتغيرات سياق الاسترجاع. يهدف هذا الهرم إلى وضع إطار تحليلي منظم يربط الجاهزية البنيوية بالظهور المشهود في مخرجات النماذج.
                        ▲
                       / \
                      /   \
                     / L5  \   5. Zero-Prompt Agentic Mindshare
                    /-------\     الحصة الذهنية الوكيلة دون طلب مباشر
                   /   L4    \   4. Multi-LLM Citation & Source Trust
                  /-----------\     الاستشهاد متعدد النماذج وموثوقية المصدر
                 /     L3      \   3. RAG Retrieval & Contextual Alignment
                /---------------\     تحسين استرجاع RAG والتقطيع السياقي
               /       L2        \   2. Entity Authority & Knowledge Graph
              /-------------------\     سلطة الكيان واتساق الرسم البياني للمعرفة
             /         L1          \   1. Grounded Data & Machine Infrastructure
            /-----------------------\     البيانات الموثقة والبنية التحتية المقروءة آلياً
۲. مبدأ الفصل بين المقاييس: الدقة العلمية مقابل الادعاءات التسويقية
في كافة تحليلات هذا الإطار، نلتزم بالتمييز القاطع التالي:
$$\text{ذكر الاسم (Mention)} \neq \text{الاستشهاد (Citation)} \neq \text{التوصية (Recommendation)} \neq \text{الترتيب (Position)} \neq \text{الحصة من النموذج (Share of Model)}$$
ذكر الاسم (Mention):* مجرد ورود اسم العلامة التجارية في النص المولد دون رابط أو مرجع قابل للنقر.
الاستشهاد بالمصدر (Citation):* تضمين رابط نشط أو حاشية توجه المستخدم مباشرة إلى أصل من أصول العلامة التجارية.
التوصية بالحل (Recommendation):* اقتراح النموذج الصريح للعلامة كحل موثوق ومعتمد لاحتياج المستخدم.
الترتيب في القائمة (Position):* موقع العلامة ضمن الخيارات المقترحة (المرتبة الأولى، الثانية، إلخ).
الحصة من مخرجات النموذج (Share of Model):* نسبة تكرار ذكر العلامة مقارنة بالكيانات المنافسة في قطاع محدد.
۳. التحليل التفصيلي لطبقات الهرم الخمس
۳.۱. الطبقة الأولى: البيانات الموثقة والبنية التحتية المقروءة آلياً (L1)
تمثل الطبقة الأساسية لهرم GEO لمولوي. في هذا المستوى، يجب أن تكون الأصول الرقمية مهيأة للزواحف الآلية وأنظمة RAG بسلاسة ودون عوائق برمجية.
HTML الدلالي و DOM النظيف:* استخدام وسوم HTML الدلالية القياسية (<article>، <section>، <header>) وهرمية العناوين دون أطر JavaScript الفارغة.
الرسوم البيانية للكيانات عبر JSON-LD: تطبيق مخططات Schema.org القياسية (`Organization`، `Person`، `ScholarlyArticle`، `DefinedTerm`). تنبيه علمي:* البيانات المنظمة تعزز الفهم الآلي وأهلية الظهور (Eligibility)، لكنها وحدها لا تمنح سلطة خوارزمية أو تضمن الاستشهاد.
ميثاق الناشرين llms.txt (llms.txt Publisher Convention):* تقديم ملف /llms.txt كمقترح ناشرين ناشئ لتسهيل القراءة الآلية السريعة؛ وليس معياراً إلزامياً أو عامل ترتيب رسمي (أكدت Google رسمياً أن المشاركة في ميزات الذكاء الاصطناعي لا تتطلب ملفات خاصة).
إمكانية الزحف غير المقيدة:* إتاحة الوصول لزواحف الذكاء الاصطناعي الرسمية (GPTBot، PerplexityBot، ClaudeBot، Applebot، Google-Extended).
۳.۲. الطبقة الثانية: سلطة الكيان وتطابق الرسم البياني للمعرفة (L2)
في هذه الطبقة، تتعرف نماذج التوليد على العلامة ككيان مستقل وغير ملتبس ضمن الرسوم البيانية للمعرفة.
فك الالتباس (Disambiguation):* بناء تعريف فريد وموثق للعلامة في المنصات المستقلة المعتمدة.
التواجد المتزامن (Co-occurrence):* اقتران اسم العلامة بالمفاهيم التخصصية المحورية في مصادر خارجية موثوقة.
ربط الهويات SameAs:* دمج الحسابات الرقمية عبر GitHub و ORCID والمستودعات العلمية ضمن جذر كيان موحد.
۳.۳. الطبقة الثالثة: استرجاع RAG والتقطيع السياقي (L3)
تهتم الطبقة الثالثة بإعداد المحتوى للبحث المتجهي (Vector Search) واسترجاع المقاطع الدلالية.
نسبة كثافة المعلومات (Information Density Ratio):* إزالة الحشو البلاغي وتقديم الحقائق المباشرة في مستهل كل مقطع.
المقاطع المكتفية ذاتياً (Self-Contained Chunks):* ضمان احتفاظ كل فقرة بسياق الكيان وموضوعه عند تقطيعها بواسطة خوارزميات RAG.
معمارية الاضطراب المتجهي (VPA):* تقليل الإنتروبيا الدلالية أثناء استرجاع المقاطع العصبية.
۳.۴. الطبقة الرابعة: الاستشهاد متعدد النماذج وموثوقية المصدر (L4)
تختار محركات البحث الذكية (مثل ChatGPT Search و Perplexity و Google AI Overviews) العلامة كمصدر موثوق للاستشهاد وتضمين الروابط.
ملكية البيانات الأولية (Primary Data Ownership):* نشر أبحاث ومعايير أصلية يضطر الخبراء للاستشهاد بها.
التحقق عبر المصادر المتعددة (Cross-Corpus Validation):* تكرار الفرضية في عدة مراجع مستقلة يعزز احتمال الاستشهاد؛ وتظل فرضية معقولة تتطلب تجارب منضبطة لإثبات السببية.
تنسيق الاستشهاد القياسي:* توفير صيغ الاستشهاد بصيغة APA و BibTeX وروابط أصلية دائمة.
۳.۵. الطبقة الخامسة: الحصة الذهنية الوكيلة دون طلب مباشر (L5)
قمة الهرم؛ حيث يقترح النموذج الذكي إطار عمل العلامة كحل قياسي دون أن يذكر المستخدم اسم العلامة في الطلب.
السيادة التعريفية على الفئة (Category Definitional Dominance):* ارتباط اسم العلامة بالحل القياسي لمعضلة تقنية.
أدوات الوكلاء الافتراضية:* توفير خوادم بروتوكول سياق النموذج (MCP) وبيانات حية يعتمد عليها الوكلاء الأذكياء.
التوصية دون طلب مباشر (Zero-Prompt Recommendation):* ترشيح العلامة تلقائياً في الأسئلة العامة.
٤. جدول المطابقة بين الهرم الاستراتيجي ومقاييس MAVI التشغيلية
| الطبقة | هرم مولوي الاستراتيجي | مقياس MAVI التشغيلي | نوع الأدلة | المخرج القابل للقياس | القيد المنهجي |
|---|---|---|---|---|---|
| L1 | البيانات الموثقة والبنية التحتية | إمكانية الوصول التقنية | سجلات الزحف، أكواد HTTP، سلامة SSR | درجة الوصول التقني (۰–۱۰۰) | إمكانية الزحف لا تضمن الاستشهاد. |
| L2 | سلطة الكيان ورسم المعرفة | القابلية للاستخراج الدلالي ووضوح الكيان | فحص مخططات JSON-LD، ثبات الإشارات | درجة الاستخراج ووضوح الكيان | المخططات وحدها لا تصنع سلطة مرجعية. |
| L3 | استرجاع RAG والتقطيع السياقي | كثافة المقاطع وملائمة الاسترجاع | متجهات الاستعلامات، تشابه الجيب تماماً | معدل الاسترجاع وملاءمة المقاطع | الاسترجاع المتجهي لا يعني بالضرورة الدمج النصي. |
| L4 | الاستشهاد متعدد النماذج | جاهزية الاستشهاد ومؤشر بقاء المصدر | استشهادات الطرف الثالث، التوثيق المشترك | معدل الاستشهاد المشهود ودرجة CSP | الجاهزية النظرية تختلف عن الاستشهاد الفعلي. |
| L5 | الحصة الذهنية الوكيلة | الظهور التجريبي في الذكاء الاصطناعي | اختبارات متكررة غير موجهة في النماذج الحية | نسبة التوصية دون طلب مباشر (%) | مخرجات النماذج احتمالية وتتغير بمرور الوقت. |
٥. مصفوفة النظريات والأدلة وقابلية الدحض (Falsifiability)
| الطبقة | الادعاء النظري | الحالة العلمية | الأدبيات الداعمة | شروط الدحض والتشكيك في الادعاء |
|---|---|---|---|---|
| L1 | بنية DOM الدلالية ضرورية للقراءة الآلية الموثوقة. | Supported | مستندات Google Search Central الرسمية؛ معايير W3C. | ظهور صفحات تعتمد كلياً على JavaScript فارغ وبلا نصوص في السورس كمصادر أساسية مكررة في إجابات الذكاء الاصطناعي. |
| L2 | المخططات المتسقة تزيل اللبس في رسوم المعرفة البيانية. | Partially Supported | مواصفات Schema.org؛ أدبيات فك الالتباس في Wikidata. | إثبات قدرة النماذج اللغوية على تمييز الكيانات في النصوص غير المنظمة بذات الدقة دون أي مساعدة من المخططات. |
| L3 | المقاطع المكتفية ذاتياً ترفع استرجاع المقاطع المتجهية. | Supported | أبحاث الاسترجاع الكثيف (Karpukhin et al.؛ arXiv:2311.09735). | تسجيل النصوص الطويلة والمفككة لدرجات تشابه متجهي أعلى بانتظام مقارنة بالمقاطع المحسنة ذات الكثافة العالية. |
| L4 | التوثيق المشترك عبر المصادر يرفع احتمالية الاستشهاد. | Plausible but Untested | ملاحظات البحث التوليدي (arXiv:2509.08919). | تجارب منضبطة تثبت أن التواجد عبر نطاقات متعددة لا يحدث أي فارق إحصائي مقارنة بالنشر في نطاق واحد مكافئ. |
| L5 | السيادة التعريفية تقود للتوصية التلقائية دون طلب. | Plausible but Untested | ملاحظات نوعية عبر نماذج الاستدلال المنطقي. | اختبارات ٥٠٠ استعلام تجريدي تختار فيها النماذج بانتظام حلولاً عامة وتتجاهل استدعاء الأطر المنهجية الموثقة. |
٦. ما لا يدعيه الهرم (What the Pyramid Does Not Claim)
- لا ضمان للتصنيف أو الاستشهاد: إتمام الطبقات L1 إلى L3 يوفر الأهلية التقنية، ولا يشكل ضماناً إلزامياً للاستشهاد.
- غياب الحتمية الرياضية: بسبب التحديثات الدورية وتغير درجات حرارة النماذج، يعد الهرم خريطة تحسين وليس معادلة حتمية.
- لا ضمان مباشر للأرباح أو الزيارات: الورود في الإجابات التوليدية لا يترجم بالضرورة إلى نقرات مباشرة أو عوائد مالية.
۷. SEO يظل الأساس: التكامل البنيوي بين SEO و GEO
لا يحل GEO محل SEO بل يبنى فوقه. تشترط محركات البحث الذكية للظهور في الإجابات التوليدية الالتزام بالمعايير الأساسية: الزحف السريع، البروتوكولات الآمنة، والمحتوى الموثوق. دون أساس تقني راسخ لـ SEO، تعجز المحركات التوليدية عن فهرسة المحتوى اللازم لعمليات التركيب اللاحقة.
۸. ملاحظات بروتوكول القياس
التكرار:* الاستعلام الفردي يفتقر للدلالة الإحصائية؛ يجب تكرار كل پرامپت من ۳ إلى ۵ مرات في أوقات متفرقة.
إعادة الصياغة:* اختبار صياغات متعددة لنوايا البحث المختلفة.
تسجيل بيئة التشغيل:* توثيق نسخ النماذج بدقة، مع التوقيت، ولغة البحث، والبلد.
۹. الأسئلة البحثية الشائعة
۱. كيف يختلف هرم GEO لمولوي عن قوائم SEO التقليدية؟
يستهدف SEO التقليدي صفحات نتائج البحث. بينما يؤهل هرم GEO الكيانات لعمليات التقطيع والتخزين المتجهي واستدلال النماذج اللغوية.
۲. هل يضمن ملف llms.txt الظهور في إجابات الذكاء الاصطناعي؟
كلا. ملف llms.txt هو مقترح ناشرين ناشئ، وتؤكد Google عدم وجود متطلبات لملفات مخصصة لميزات الذكاء الاصطناعي.
۳. لماذا يجب فصل الجاهزية البنيوية (Readiness) عن الظهور المشهود (Observed Visibility)؟
قد يمتلك الموقع جاهزية تقنية كاملة لكنه يفتقر للسلطة الخارجية فلا يظهر في أي إجابة؛ والخلط بينهما تضليل تسويقي.
۴. هل يدعي الإطار فك شفرات خوارزميات الذكاء الاصطناعي؟
كلا، بل هو نموذج هندسي لتنظيم الأصول الرقمية لتقنيات الاسترجاع العصبي والتركيب الحديثة.
۵. لماذا قد تفشل صفحة محسنة في نيل الاستشهاد في الطبقة L4؟
يرجع ذلك لضعف التوثيق في المصادر المستقلة أو عدم توافق حدود التقطيع مع متجهات الاستعلام.
۶. لماذا تعد تجربة ۵۰ پرامپت مجرد نموذج تصميمي؟
حجم العينة يرتبط باتساع المجال؛ ٥٠ پرامپت يمثل خط أساس نوعي فقط، بينما تتطلب تدقيقات المؤسسات مئات الاستعلامات.
۷. هل يمنح وسم Schema.org سلطة مباشرة للكيان؟
كلا، بل يوفر دقة الفهم الدلالي؛ بينما تنبع السلطة من الأدلة الخارجية المستقلة والبيانات الأصلية.
۸. كيف يتم قياس هذه الطبقات عملياً؟
عبر مؤشر مولوي للظهور في الذكاء الاصطناعي (MAVI) الذي يحول الهرم إلى مقاييس كمية قابلة للاختبار.
۱۰. سجل الإصدارات وطريقة الاستشهاد
الإصدار ۱.۰ (يوليو ۲۰۲۶):* إطلاق إطار سلطة الكيانات خماسي الطبقات ومعادلة MAVI الأساسية.
الإصدار ۱.۱ (أكتوبر ۲۰۲۶):* تعزيز الدقة العلمية: ميثاق الناشرين لـ llms.txt، جدول مطابقة MAVI، مصفوفة الدحض، وفصل Mention عن Citation.
للاطلاع على بروتوكول القياس العملي، راجع وثيقة مؤشر مولوي للظهور في الذكاء الاصطناعي (MAVI) وأدوات SAGE و GEO-Scope.