White paper
Molavi GEO Piramidi: Beş Katmanlı Çerçeve
InTen’de kıdemli SEO stratejisti ve GEO sistemleri mimarı olan Taghi Molavi bu konuyu inceliyor.
Yönetici özeti
Makine tarafından okunabilir veriden zero-prompt agentic mindshare seviyesine uzanan beş katmanlı GEO metodolojisi.
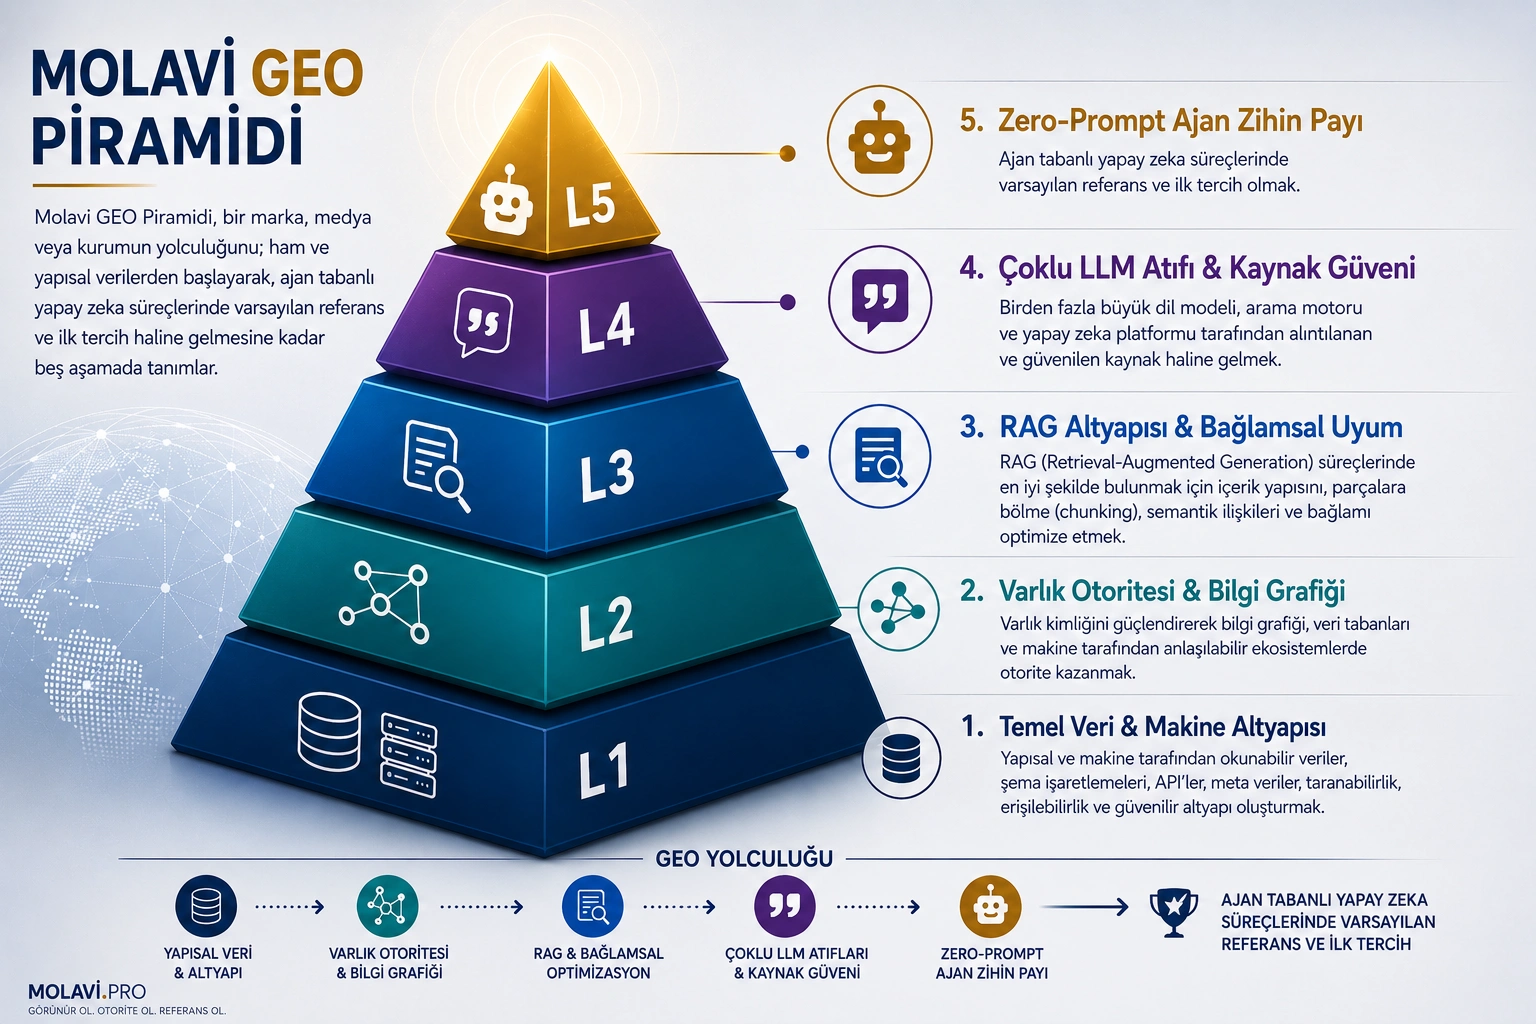
Varlık Otoritesi ve Üretken Motor Optimizasyonu İçin 5 Katmanlı Çerçeve
Yazar ve Geliştirici: Taqi Molavi
Yayıncı: Molavi Ar-Ge Düşünce Kuruluşu (molavi.pro/research)
Sürüm: 1.1, Ekim 2026 (Sürüm 1.0 Temmuz 2026'dan güncellendi)
Alıntı: Molavi, T. (2026). The Molavi GEO Pyramid: A 5-Layer Framework for Entity Authority and Generative Engine Optimization. Molavi R&D Think Tank. https://molavi.pro/tr/research/geo-pyramid
1. Giriş, Araştırma Konumlandırması ve Yönetici Özeti
SEO (Arama Motoru Optimizasyonu) alanından GEO (Üretken Motor Optimizasyonu) yaklaşımına geçiş, yalnızca anahtar kelimelerin veya geleneksel bağlantı inşasının değişmesi değildir. Bu değişim, web adreslerinin dizine eklenmesinden, Büyük Dil Modelleri (LLM'ler) ve hibrit RAG sistemleri tarafından varlıkların (Entity) anlaşılması, çıkarılması ve sentezlenmesine doğru köklü bir paradigma dönüşümüdür.
Araştırma Konumlandırması ve Metodolojik Kapsam
Molavi GEO Piramidi, üretken yapay zeka çağında marka ve varlık otoritesini yapılandırmak için önerilen kavramsal ve stratejik bir modeldir. Bu model, OpenAI, Google, Anthropic veya Perplexity'nin tescilli arama algoritmalarını tersine mühendislikle çözdüğünü iddia etmez. Modern yapay zeka sistemleri stokastik (olasılıksal) çalışır; model güncellemeleri, sıcaklık ayarları ve bağlamsal arama değişkenleri sonuçları sürekli etkiler. Piramidin amacı, altyapı hazırlığından modellerin zihnindeki gözlemlenebilir varlığa kadar analitik bir düzen kurmaktır.
                        ▲
                       / \
                      /   \
                     / L5  \   5. Doğrudan İstem Olmadan Ajan Zihin Payı
                    /-------\     Varsayılan Ajan Önerisi ve Zihin Payı
                   /   L4    \   4. Çoklu Model Alıntısı ve Kaynak Güveni
                  /-----------\     Çapraz Külliyat Doğrulaması ve Atıf
                 /     L3      \   3. RAG Erişimi ve Bağlamsal Uyum
                /---------------\     Yoğun Pasaj Erişimi ve Parçalama (Chunking)
               /       L2        \   2. Varlık Otoritesi ve Bilgi Grafiği
              /-------------------\     Varlık Anlam Ayrımı ve Birlikte Geçiş
             /         L1          \   1. Temellendirilmiş Veri ve Makine Altyapısı
            /-----------------------\     Makine Okunabilirliği ve Teknik Erişilebilirlik
2. Metrik Ayrımı İlkesi: Pazarlama İddialarına Karşı Ölçülebilir Gerçekler
Bu çerçevenin tüm analizlerinde şu kesin ayrım geçerlidir:
$$\text{Adın Geçmesi (Mention)} \neq \text{Alıntı (Citation)} \neq \text{Öneri (Recommendation)} \neq \text{Sıralama (Position)} \neq \text{Model Payı (Share of Model)}$$
Adın Geçmesi (Mention):* Modelin ürettiği metin içerisinde marka adının yalnızca geçmesi (tıklanabilir bağlantı veya kaynak olmadan).
Alıntı (Citation):* Markanın doğrulanmış varlığına yönlendiren açık, tıklanabilir bir dipnot veya kaynak bağlantısının sunulması.
Çözüm Önerisi (Recommendation):* Modelin, kullanıcının belirli sorununu çözmek için markayı açıkça doğrulanmış bir çözüm olarak tavsiye etmesi.
Sıralama Konumu (Position):* Önerilen seçenekler listesinde markanın sıralamadaki yeri (1., 2. vb.).
Model Payı (Share of Model):* Belirli bir konu kümesinde markanın üretilme sıklığının rakip varlıklara oranı.
3. Beş Katmanın Ayrıntılı İncelemesi
3.1. Katman 1: Temellendirilmiş Veri ve Makine Altyapısı (L1)
Piramidin temel katmanı, otomatik tarayıcıların, başsız ayrıştırıcıların ve RAG ajanlarının web içeriğini işleme hızını ve kalitesini belirler.
Anlamsal HTML ve Temiz DOM:* Boş JavaScript kabukları yerine standart HTML etiketleri (<article>, <section>, <header>) ve düzenli başlık hiyerarşisi kullanmak.
JSON-LD Varlık Grafikleri: Standartlaştırılmış Schema.org işaretlemeleri (`Organization`, `Person`, `ScholarlyArticle`, `DefinedTerm`). Bilimsel sınır:* Yapılandırılmış veri makinelerin anlamasını ve uygunluğu (Eligibility) artırır; tek başına algoritmik otorite veya alıntı garantisi sağlamaz.
llms.txt Yayıncı Sözleşmesi (llms.txt Publisher Convention):* Önemli kaynakları özetlemek için geliştirilen gelişmekte olan bir yayıncı uzlaşısıdır; zorunlu bir kural veya resmi sıralama faktörü değildir (Google, AI Overviews için özel bir dosya gerekmediğini açıkça belirtmektedir).
Engelsiz Tarayıcı Erişimi:* Doğrulanmış yapay zeka tarayıcıları (GPTBot, PerplexityBot, ClaudeBot, Applebot, Google-Extended) için açık tarama politikası.
3.2. Katman 2: Varlık Otoritesi ve Bilgi Grafiği Uyumu (L2)
İkinci katmanda üretken modeller, markayı bilgi grafiklerinde bağımsız ve net bir düğüm (Node) olarak tanımlar.
Varlık Anlam Ayrımı (Disambiguation):* Güvenilir kaynaklarda ve veri tabanlarında marka için tekil ve açık bir tanım oluşturmak.
Bağlamsal Birlikte Geçiş (Co-occurrence):* Markanın, sektörün temel kavramlarıyla saygın bağımsız kaynaklarda yan yana anılması.
SameAs Kimlik Eşlemesi:* GitHub, ORCID ve kurumsal platformlardaki dijital kimliklerin tek bir varlık kökünde birleştirilmesi.
3.3. Katman 3: RAG Erişimi ve Bağlamsal Parçalama (L3)
Üçüncü katman, içeriği vektör gömmeleri (Vector Embeddings) ve anlamsal erişim için optimize eder.
Bilgi Yoğunluğu Oranı (Information Density Ratio):* Gereksiz dolgu metinlerini kaldırmak ve doğrudan doğrulanabilir olguları sunmak.
Kendi Kendine Yeterli Parçalar (Self-Contained Chunks):* Her paragrafın veya bölümün, ayrıştırıldığında bile varlık bağlamını ve anlam bütünlüğünü koruması.
Vektör Bozulma Mimarisi (VPA):* Sinirsel pasaj erişimi sırasında anlamsal entropiyi azaltacak metin yapıları.
3.4. Katman 4: Çoklu Model Alıntısı ve Kaynak Güveni (L4)
Bu katmanda üretken arama motorları (ChatGPT Search, Perplexity ve Google AI Overviews dahil) markayı yetkili bir kaynak olarak gösterir ve alıntılar.
Birincil Veri Sahipliği (Primary Data Ownership):* Başkalarının atıfta bulunmak zorunda kaldığı özgün araştırmalar ve veriler yayınlamak.
Çapraz Külliyat Doğrulaması (Cross-Corpus Validation):* Bir iddianın birden fazla bağımsız kaynakta yer almasının alıntı ihtimalini artırdığı hipotezi makuldür; ancak nedensel kesinlik için kontrollü deneyler gerekir.
Standart Alıntı Biçimlendirmesi:* APA, BibTeX ve kalıcı kanonik bağlantılar sunmak.
3.5. Katman 5: Doğrudan İstem Olmadan Ajan Zihin Payı (L5)
Piramidin zirvesi, otonom akıl yürütme modellerinin markasız genel bir soruya yanıt verirken markanın çerçevesini varsayılan çözüm olarak önerdiği aşamadır.
Kategori Tanımlayıcı Hakimiyeti:* Markanın, sektördeki temel bir sorunun standart çözümüyle özdeşleşmesi.
Varsayılan Ajan Araçları:* Ajanların kullandığı Model Context Protocol (MCP) sunucuları ve açık API'ler sağlamak.
Doğrudan İstem Olmadan Öneri (Zero-Prompt Recommendation):* Modelin, markanın adı geçmediğinde dahi onu öneri olarak sunması.
4. Stratejik Piramit ↔ Operasyonel MAVI Eşleştirme Tablosu
Kavramsal piramit ile teşhis amaçlı MAVI (Molavi Yapay Zeka Görünürlük İndeksi) arasındaki ilişkiyi netleştiren eşleştirme tablosu:
| Katman | Stratejik Piramit | Operasyonel MAVI Metriği | Kanıt Türü | Ölçülebilir Çıktı | Metodolojik Sınır |
|---|---|---|---|---|---|
| L1 | Temellendirilmiş Veri ve Makine Altyapısı | Teknik Erişilebilirlik | Tarama kayıtları, HTTP durum kodları, SSR bütünlüğü | Teknik Erişilebilirlik Puanı (0–100) | Tarama erişimi, yanıtlarda yer almayı garanti etmez. |
| L2 | Varlık Otoritesi ve Bilgi Grafiği | Anlamsal Çıkarılabilirlik ve Varlık Netliği | JSON-LD şema doğrulaması, varlık çapraz referansları | Çıkarılabilirlik ve Varlık Netliği Puanı | Şema tek başına otorite veya güven yaratmaz. |
| L3 | RAG Erişimi ve Bağlamsal Uyum | Pasaj Bağlamsal Yoğunluğu ve Erişim Uyumu | Sentetik sorgu gömmeleri, kosinüs benzerliği | Erişim Oranı ve Parça Uyumu | Vektör erişimi, metin sentezine dahil edilmeyle aynı değildir. |
| L4 | Çoklu Model Alıntısı ve Kaynak Güveni | Alıntı Hazırlığı / Alıntı Hayatta Kalma Göstergesi | Üçüncü taraf atıfları, çapraz külliyat doğrulaması | Gözlemlenen Alıntı Oranı ve CSP Puanı | Hazırlık puanı, canlı alıntıyı garanti etmez. |
| L5 | Doğrudan İstem Olmadan Ajan Zihin Payı | Ampirik Yapay Zeka Görünürlüğü | Canlı motorlarda tekrarlanan markasız testler | Doğrudan İstem Olmadan Öneri Oranı (%) | LLM çıktıları olasılıksaldır ve zamanla değişir. |
5. Teori, Kanıt ve Yanlışlanabilirlik Matrisi
| Katman | Teorik İddia | Bilimsel Durum | Destekleyen Literatür | Yanlışlanabilirlik Ölçütleri |
|---|---|---|---|---|
| L1 | Anlamsal DOM yapısı, güvenilir makine okuması için zorunludur. | Supported | Google Search Central belgeleri; W3C standartları. | İstemci taraflı boş JavaScript sayfalarının, önceden işlenmiş HTML sayfalarıyla aynı sıklıkta kaynak gösterilmesi. |
| L2 | Tutarlı şema, bilgi grafiklerindeki belirsizliği giderir. | Partially Supported | Schema.org özellikleri; Wikidata varlık literatürü. | LLM'lerin hiçbir yapısal veri olmayan sayfalarda da varlıkları aynı doğrulukla ayırt edebildiğinin gösterilmesi. |
| L3 | Yüksek bilgi yoğunluğuna sahip bağımsız parçalar vektör erişimini artırır. | Supported | Yoğun Pasaj Erişimi literatürü (Karpukhin ve ark.; arXiv:2311.09735). | Dağınık ve uzun metinlerin, optimize edilmiş parçalardan daha yüksek erişim benzerliği elde etmesi. |
| L4 | Çoklu külliyatta doğrulanma alıntı olasılığını artırır. | Plausible but Untested | Üretken arama gözlemleri (arXiv:2509.08919). | Çoklu alan adı yayınlarının tek alan adı yayınına göre alıntı oranında hiçbir fark yaratmadığını gösteren kontrollü deneyler. |
| L5 | Kategori tanımlayıcı hakimiyeti istem olmadan öneri sağlar. | Plausible but Untested | Akıl yürütme modellerinde nitel gözlemler. | 500 markasız sorguda modellerin tutarlı olarak jenerik çözümleri tercih edip yapılandırılmış çerçeveyi çağırmaması. |
6. Piramidin İddia Etmediği Hususlar
- Sıralama veya Alıntı Garantisi Yoktur: L1-L3 katmanlarını tamamlamak teknik uygunluk sağlar; alıntıyı garanti etmez.
- Deterministik Kesinlik Yoktur: Modellerin haftalık güncellemeleri nedeniyle piramit deterministik bir formül değil, optimizasyon haritasıdır.
- Doğrudan Gelir veya Trafik Garantisi Yoktur: Yapay zeka özetinde yer almak, doğrudan web sitesi tıklaması veya gelir artışı anlamına gelmez.
7. SEO Temel Olarak Kalır: SEO ve GEO Birlikteliği
GEO, SEO'nun yerini almaz; onun üzerine inşa edilir. Google'ın resmi belgelerinde vurguladığı gibi, yapay zeka arama özelliklerine dahil olmanın ön koşulu temel arama standartlarıdır: hızlı tarama, güvenli protokoller ve kaliteli içerik. Teknik SEO altyapısı olmadan, üretken motorlar içeriği dizine ekleyemez ve sentezleyemez.
8. Ölçüm Metodolojisi Notları
Bu çerçeveye dayalı her ampirik ölçüm şu standartlara uymalıdır:
Tekrarlanan Çalıştırmalar:* Tek bir sorgu istatistiksel değer taşımaz. Her istem farklı zamanlarda 3-5 kez yinelenmelidir.
Sorgu Varyasyonları:* Farklı niyet kategorilerinde birden fazla ifade test edilmelidir.
Yürütme Kaydı:* Model sürümleri, zaman damgaları, kullanıcı konumu ve arama durumu tam olarak kaydedilmelidir.
9. Araştırma Sıkça Sorulan Sorular (SSS)
1. Molavi GEO Piramidi klasik SEO kontrol listelerinden nasıl ayrılır?
Klasik SEO arama sonuç sayfalarını hedefler. Molavi GEO Piramidi, varlıkları parçalama, vektör depolama ve LLM akıl yürütme süreçlerine hazırlar.
2. llms.txt uygulamak yapay zeka görünürlüğünü garanti eder mi?
Hayır. llms.txt gelişmekte olan bir yayıncı uzlaşısıdır. Google, yapay zeka özellikleri için özel bir dosya gerekmediğini açıkça belirtir.
3. Yapısal Hazırlık (Readiness) ile Gözlemlenen Görünürlük (Observed Visibility) neden ayrılmalıdır?
Bir site teknik olarak mükemmel hazırlanmış olabilir ancak harici otoritesi olmadığı için hiçbir yanıtta yer almayabilir. İkisini karıştırmak yanıltıcıdır.
4. Bu çerçeve tescilli yapay zeka modellerini çözdüğünü iddia ediyor mu?
Hayır. Modern sinirsel erişim mimarileri için tasarlanmış mühendislik modelidir.
5. İyi optimize edilmiş bir sayfa neden Katman 4'te alıntı alamayabilir?
Yetersiz üçüncü taraf doğrulaması, uyumsuz metin parçalama sınırları veya model sıcaklık dalgalanmaları nedeniyle olabilir.
6. 50 istemlik kıyaslama neden evrensel bir kural değildir?
Örneklem büyüklüğü alanın karmaşıklığına bağlıdır; 50 istem yalnızca bir başlangıç tasarımıdır.
7. Schema.org işaretlemesi doğrudan otorite sağlar mı?
Hayır. Şema yalnızca anlam ayrımı sağlar; gerçek otorite bağımsız kanıtlardan gelir.
8. Bu katmanlar uygulamada nasıl ölçülür?
Piramidi ölçülebilir puanlara dönüştüren Molavi Yapay Zeka Görünürlük İndeksi (MAVI) aracılığıyla.
10. Sürüm Geçmişi ve Alıntı
Sürüm 1.0 (Temmuz 2026):* 5 katmanlı varlık otoritesi çerçevesi ve temel MAVI formülü yayınlandı.
Sürüm 1.1 (Ekim 2026):* Bilimsel güçlendirme: llms.txt yayıncı uzlaşısı olarak netleştirildi, Piramit ↔ MAVI tablosu, yanlışlanabilirlik matrisi ve araştırma SSS eklendi.
Operasyonel ölçüm protokolü için Molavi Yapay Zeka Görünürlük İndeksi (MAVI) belgesini ve açık kaynaklı SAGE ile GEO-Scope araçlarını inceleyebilirsiniz.