سند پژوهشی
هرم GEO مولوی؛ چارچوب پنجلایه دیده شدن برند
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
خلاصه اجرایی
سند متدولوژی و چارچوب اختصاصی برای حرکت از دادههای پایه و خوانش ماشین تا مرجعیت پیشفرض در پاسخهای ایجنتی هوش مصنوعی.
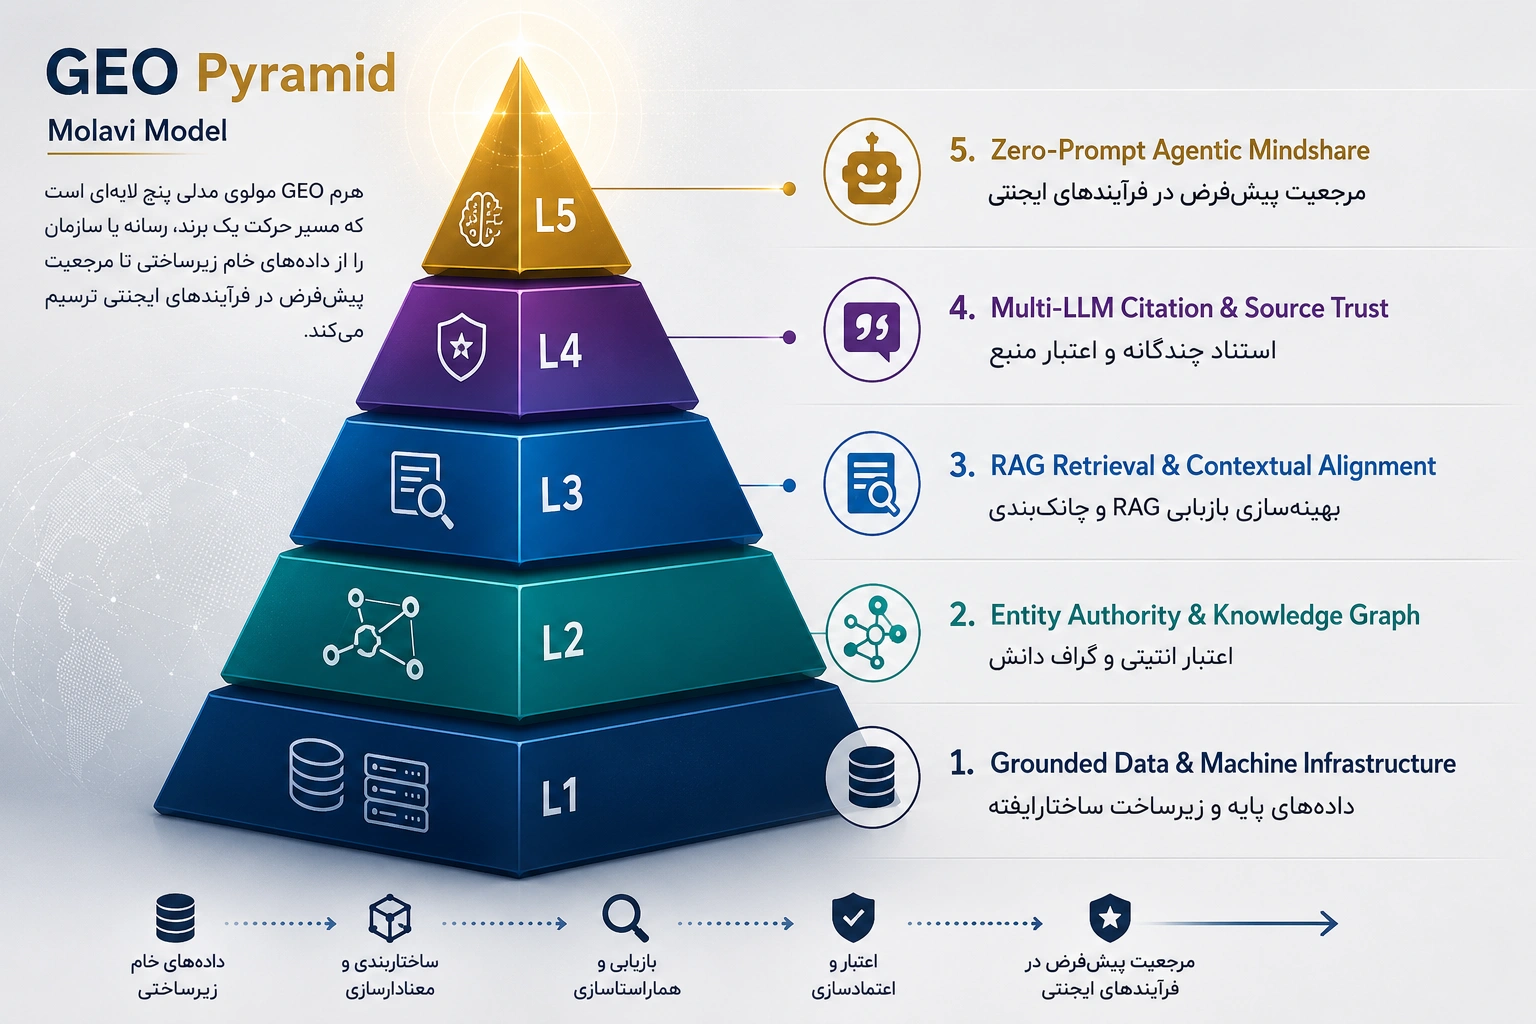
چارچوب ۵ لایهای مرجعیت انتیتی و بهینهسازی برای موتورهای جستجوی هوش مصنوعی
نویسنده و تدوینکننده: تقی مولوی (Taqi Molavi)
ناشر: اندیشکده تحقیق و توسعه برند تقی مولوی (molavi.pro/research)
نسخه: ۱.۱، اکتبر ۲۰۲۶ (بروزرسانی از نسخه ۱.۰ ژوئیه ۲۰۲۶)
نحوه استناد: Molavi, T. (2026). The Molavi GEO Pyramid: A 5-Layer Framework for Entity Authority and Generative Engine Optimization. Molavi R&D Think Tank. https://molavi.pro/research/geo-pyramid
۱. مقدمه، جایگاه پژوهشی و چکیده اجرایی
انتقال از SEO (Search Engine Optimization) به GEO (Generative Engine Optimization) صرفاً تغییر در کلمات کلیدی یا لینکسازی سنتی نیست. این تغییر، حرکت از نمایهسازی آدرسهای وب به درک، استخراج و سنتز انتیتیها توسط مدلهای زبانی بزرگ (LLMs) و سامانههای بازیابی ترکیبی است.
جایگاه پژوهشی و روششناختی هرم (Research Positioning)
هرم GEO مولوی یک چارچوب مفهومی و راهبردی پیشنهادی برای سازماندهی مسئلهٔ مرجعیت برند در عصر هوش مصنوعی است. این مدل ادعای مهندسی معکوس (Reverse Engineering) الگوریتمهای اختصاصی یا محرمانه شرکتهای OpenAI، Google، Anthropic یا Perplexity را ندارد. در سامانههای جستجوی زایشی مدرن، رفتار مدلها تصادفی (Stochastic)، متغیر با دما و وابسته به زمینهٔ بازیابی است. هدف این هرم، ایجاد نظم تحلیلی میان اقدامات زیرساختی تا نتایج مشاهدهپذیر در ذهن مدلهاست.
▲
/ \
/ \
/ L5 \ 5. Zero-Prompt Agentic Mindshare
/-------\ مرجعیت پیشفرض در فرآیندهای ایجنتی
/ L4 \ 4. Multi-LLM Citation & Source Trust
/-----------\ استناد چندگانه و اعتبار منبع
/ L3 \ 3. RAG Retrieval & Contextual Alignment
/---------------\ بهینهسازی بازیابی RAG و چانکبندی
/ L2 \ 2. Entity Authority & Knowledge Graph
/-------------------\ اعتبار انتیتی و گراف دانش
/ L1 \ 1. Grounded Data & Machine Infrastructure
/-----------------------\ دادههای پایه و زیرساخت ساختاریافته۲. اصل تفکیک سنجهها: ادعاهای قابل سنجش در برابر برداشتهای بازاریابی
در تمام تحلیلهای این چارچوب، تمایز قطعی زیر برقرار است:
$$\text{Mention} \neq \text{Citation} \neq \text{Recommendation} \neq \text{Position} \neq \text{Share of Model}$$
ذکر نام (Mention):* صرف اشاره به نام برند یا محصول در متن پاسخ مدل (بدون لینک یا ارجاع).
استناد مستقیم (Citation):* ارائه پیوند فعال، پانوشت یا منبع قابل کلیک هدایتکننده به دامنه یا سند برند.
پیشنهاد راهحل (Recommendation):* تأیید و پیشنهاد صریح برند توسط مدل به عنوان پاسخ به نیاز خاص کاربر.
جایگاه در فهرست (Position):* اولویت ترتیبی برند در بین گزینههای پیشنهادی مدل (رتبه اول، دوم یا...).
سهم از خروجی مدل (Share of Model):* درصد حجم یا بسامد تولید نام برند نسبت به کل رقبای کلاستر صنعتی در پاسخهای همان مدل.
۳. بررسی تفصیلی لایههای پنجگانه هرم
۳.۱. لایه اول: دادههای پایه و زیرساخت ماشینخوان (L1)
لایه اول هرم GEO مولوی پایهایترین سطح است. در این سطح، داراییهای وب باید برای خزندهها، ایجنتها و خطوط لوله RAG خوانا، بدون خطا، سبک و با ساختار معنایی شفاف ارائه شوند.
Semantic HTML & Clean DOM:* استفاده درست از المانهای معنایی HTML (<article>، <section>، <header>) و سلسلهمراتب heading بدون کدهای اضافه و پوستههای توخالی جاوااسکریپت.
JSON-LD Entity Graphs:* پیادهسازی اسکیماهای استاندارد متصل مانند Organization، Person، ScholarlyArticle و DefinedTerm. نکتهٔ علمی: اسکیما به درک ماشین و واجد شرایط بودن (Eligibility) کمک میکند، اما بهتنهایی اعتبار یا استناد تضمین نمیکند.
توافقنامه ناشران llms.txt (llms.txt Publisher Convention):* پیادهسازی فرمت متنی /llms.txt به عنوان یک پیشنهاد نوظهور جهت دسترسی خلاصه و سریع به منابع کلیدی؛ نه به عنوان استاندارد اجباری یا فاکتور رسمی رتبهبندی. (گوگل صریحاً اعلام کرده است که برای حضور در AI Overviews نیازی به فایل یا متادیتای اختصاصی نیست).
دسترسیپذیری بدون مسدودی (Crawler Accessibility):* باز بودن دسترسی رباتهای رسمی مانند GPTBot، PerplexityBot، ClaudeBot، Applebot و Google-Extended.
۳.۲. لایه دوم: اعتبار انتیتی و همپوشانی در گراف دانش (L2)
لایه دوم جایی است که موتور هوش مصنوعی برند را به عنوان یک انتیتی مستقل و معتبر در گراف دانش بازشناسی میکند. مدلهای زبانی صرفاً توکنها را نمیشمارند؛ آنها روابط میان موجودیتها، ویژگیها و همآیندی منابع را ارزیابی میکنند.
رفع ابهام (Disambiguation):* ثبت تعریف یکتا و متمایز برای برند یا فرد در منابع ساختیافته و رسانههای معتبر.
همآیندی (Co-occurrence):* همراه شدن نام برند با مفاهیم و موجودیتهای اصلی صنعت در متون مستقل و دستاول.
نگاشت SameAs:* اتصال شفاف هویتهای توزیعشده در گیتهاب، اورکید، دانشنامهها و شبکههای اجتماعی به ریشه انتیتی.
۳.۳. لایه سوم: بهینهسازی بازیابی RAG و چانکبندی بافتی (L3)
لایه سوم، محتوا را برای جستجوی برداری (Vector Search)، چانکبندی دقیق و بازیابی معنایی آماده میسازد. در سیستمهای مدرن RAG، محتوا به برشهای متنی تقطیع میشود.
نسبت چگالی اطلاعات (Information Density Ratio):* حذف حشوهای متنی و ارائه فکتهای متراکم در ابتدای هر بخش.
چانکهای خودکفا (Self-Contained Chunks):* هر پاراگراف یا قطعه باید حامل نام انتیتی و بستر موضوعی باشد تا در صورت جداسازی، معنای مستقل خود را از دست ندهد.
معماری دستکاری برداری (VPA):* مدل کاهش آنتروپی معنایی در RAG با ایجاد فکتهای بدون ابهام، ساختار متنی منظم و جدولهای مقایسهای.
۳.۴. لایه چهارم: استناد چندگانه و اعتبار منبع (L4)
در این لایه، موتورهای جستجوی هوش مصنوعی (مانند ChatGPT Search، Perplexity و Google AI Overviews) برند را به عنوان منبع موثق برای ارجاع و Citation انتخاب میکنند.
مالکیت داده دستاول (Primary Data Ownership):* انتشار پژوهشها، بنچمارکها و چارچوبهایی که سایر رسانهها برای تبیین موضوع ناچار به ارجاع به آن باشند.
اعتبارسنجی بینپیکرهای (Cross-Corpus Validation):* تکرار و تایید یک ادعا در چندین منبع معتبر مستقل؛ این یک فرضیه معقول و تجربی است که تایید چندمنبعی احتمال citation را افزایش میدهد، هرچند برای اثبات علّی نیازمند آزمایشهای کنترلشده است.
بلوک استناد استاندارد:* درج قالبهای استاندارد استناد (APA، BibTeX) و آدرسهای کاننیکال پایدار.
۳.۵. لایه پنجم: سهمذهن ایجنتی بدون پرامپت مستقیم (L5)
لایه پنجم قله هرم است؛ نقطهای که کاربر در درخواست اولیه خود هیچ نامی از برند یا شخص نمیبرد، اما عامل هوش مصنوعی بر اساس عمق تخصص و پیوند موضوعی، چارچوب برند را به عنوان پاسخ مرجع انتخاب میکند.
سلطهٔ تعریفی بر دستهبندی (Category Definitional Dominance):* پیوند نام برند با راهحل یک مسئله ریشهای در صنعت.
ابزار پیشفرض ایجنتها:* فراهمسازی پروتکلهای MCP، دادههای زنده و APIهای عمومی که توسط ایجنتها به کار گرفته شوند.
پیشنهاد خودانگیخته (Zero-Prompt Recommendation):* مدل بدون پرسش جهتدار، برند را به عنوان استانداردی از صنعت ارائه میدهد.
۴. جدول تطبیق راهبردی و سنجههای عملیاتی (Crosswalk Table)
برای جلوگیری از خلط مبحث میان مدل مفهومی هرم و پیادهسازی تشخیصی MAVI (شاخص دیده شدن در هوش مصنوعی مولوی)، جدول تطبیقی زیر رابطهٔ این دو را معین میکند:
| سطح | لایهٔ هرم راهبردی مولوی | سنجهٔ عملیاتی MAVI | نوع شواهد (Evidence) | خروجی قابل اندازهگیری | محدودیت روششناختی |
|---|---|---|---|---|---|
| L1 | Grounded Data & Machine Infrastructure | Technical Accessibility | لاگهای کراول، وضعیت HTTP، اعتبار رندر SSR | امتیاز دسترسیپذیری فنی (۰ تا ۱۰۰) | دسترسیپذیری خزش هرگز تضمینکننده استناد نیست. |
| L2 | Entity Authority & Knowledge Graph | Semantic Extractability & Entity Clarity | همخوانی JSON-LD، ثبات گراف در منابع مستقل | امتیاز استخراجپذیری و وضوح انتیتی | اسکیما بهتنهایی مرجعیت الگوریتمی ایجاد نمیکند. |
| L3 | RAG Retrieval & Contextual Alignment | Passage Retrieval & Contextual Alignment | بازیابی برداری کوئریهای مصنوعی، شباهت کسینوسی | نرخ بازیابی چانکها و تراکم اطلاعاتی | بازیابی برداری با گنجاندهشدن در متن تولیدی یکی نیست. |
| L4 | Multi-LLM Citation & Source Trust | Citation Readiness / Citation Survival Proxy | حضور در منابع ثالث، ارجاعات متقابل مستقل | نرخ استناد مشاهدهپذیر و امتیاز CSP | آمادگی استناد (Readiness) با استناد لایو تفاوت دارد. |
| L5 | Zero-Prompt Agentic Mindshare | Empirical AI Visibility | اجرای مکرر پرامپتهای کور در موتورهای زنده | نرخ پیشنهاد بدون پرامپت برند (%) | خروجی مدلهای زبانی تصادفی، ناپایدار و متغیر با زمان است. |
۵. ماتریس ادعا، شواهد و ابطالپذیری علمی (Theory-to-Evidence & Falsifiability)
برای خروج از حیطه ادعاهای غیرعلمی و تبلیغاتی، هر سطح هرم با معیارهای ابطالپذیری و شواهد متناظر مشخص شده است:
| لایه | ادعای نظری | وضعیت علمی شواهد | شواهد مستقل معتبر | شواهد و مشاهداتی که ادعا را تضعیف یا ابطال میکنند (Falsifiability) |
|---|---|---|---|---|
| L1 | ساختار معنایی تمیز، پیشنیاز خوانش ماشین است. | Supported | مستندات رسمی Google Search Central و مشخصات W3C. | مشاهدهٔ صفحات با خطاهای شدید رندر جاوااسکریپت و بدون متن در سورس که مکرراً به عنوان منبع اصلی در پاسخهای زنده استفاده شوند. |
| L2 | اسکیما و گراف یکپارچه، ابهام انتیتی را رفع میکند. | Partially Supported | مقالات وب معنایی و مستندات گراف دانش گوگل. | نشان دادن اینکه مدلهای زبانی بدون هیچ وابستگی به دادههای ساختاریافته و تنها از روی محتوای متنی ساده، موجودیتها را با همان دقت و بدون توهم تفکیک میکنند. |
| L3 | چانکهای خودکفا با چگالی بالا نرخ بازیابی را بهبود میدهند. | Supported | پژوهشهای بازیابی متراکم (arXiv:2311.09735 و بنچمارکهای Dense Retrieval). | اثبات اینکه متنهای بسیار طولانی، پراکنده و بدون ساختار، میانگین دقت بازیابی برداری بالاتری نسبت به چانکهای بهینهشده ثبت میکنند. |
| L4 | تکرار ادعا در چند پیکرهٔ مستقل، احتمال Citation را بالا میبرد. | Plausible but Untested | مطالعات تجربی رفتار استناد در سیستمهای تولید با جستجو (arXiv:2509.08919). | آزمون کنترلشدهای که نشان دهد حضور در چندین رسانه مرجع تأثیری در ارجاع مدل نسبت به محتوای صرفاً تکمنبعی با رنک یکسان نداشته است. |
| L5 | سلطهٔ تعریفی به پیشنهاد خودانگیخته بدون پرامپت میانجامد. | Plausible but Untested | مشاهدات تجربی در پرامپتهای حل مسئله با مدلهای استدلالگر. | بنچمارک ۵۰۰ پرامپت انتزاعی که در آن مدل همواره راهحلهای عمومی را پیشنهاد دهد و هیچ چارچوب ساختیافتهای را احضار نکند. |
۶. مواردی که هرم ادعای آن را ندارد (What the Pyramid Does Not Claim)
- تضمین رتبهبندی یا استناد: اجرای کامل لایههای L1 تا L3 هیچ تضمین قطعی برای دریافت استناد از سوی مدلهای زبانی ایجاد نمیکند.
- پیشبینیپذیری قطعی: با توجه به تغییرات هفتگی در وزنها و دمای مدلها (Non-stationarity)، هرم یک نقشه بهینهسازی است، نه یک الگوریتم ریاضی پیشبین قطعی.
- تضمین ترافیک و درآمد: دریافت استناد یا ذکر نام در یک پاسخ AI، الزاماً به معنای کلیک کاربر، بازدید سایت یا افزایش درآمد تجاری نیست.
۷. سئو همچنان پایه است: رابطه ارگانیک SEO و GEO
بهینهسازی برای موتورهای هوش مصنوعی جایگزین سئو نمیشود؛ بلکه بر روی آن بنا میگردد. همانطور که گوگل بارها در مستندات رسمی خود تصریح کرده است، شروط مقدماتی حضور در قابلیتهای مولد هوش مصنوعی (مانند Google AI Overviews)، همان استانداردهای بنیادین نمایهسازی، کراول سریع، امنیت پروتکل و اعتبار محتوایی در سئوی فنی است. بدون داشتن زیرساخت سئو، موتورهای جستجوی هیبریدی اصلاً به مرحلهٔ ایندکس و سپس سنتز محتوا نخواهند رسید.
۸. نکات روششناختی اندازهگیری (Measurement Notes)
هرگونه سنجش عملیاتی بر پایهٔ این هرم باید این اصول را رعایت کند:
تکرار اجرا (Repeated Runs):* یک بار پرسیدن یک پرامپت فاقد اعتبار آماری است. هر پرامپت باید حداقل ۳ تا ۵ بار در زمانهای مجزا اجرا شود.
بازگویی پرسش (Paraphrasing):* ارزیابی باید شامل چند نگارش مختلف از یک نیت جستجو (Query Intent) باشد.
ثبت مشخصات دقیق اجرا:* ثبت نوع موتور، مدل دقیق (مانند GPT-4o یا Claude 3.5 Sonnet)، وضعیت لاگین، زبان، کشور و تاریخ بررسی.
فاصله اطمینان:* گزارش شاخصها همراه با بازهٔ عدم قطعیت و برچسبهای تفکیکشده.
۹. پرسشهای متداول پژوهشی (Research FAQ)
۱. تفاوت اصلی هرم GEO مولوی با چکلیستهای مرسوم سئو چیست؟
سئوی سنتی صفحات را برای کلمات کلیدی و رتبهبندی پیوندها بهینه میکند. هرم GEO محتوا و انتیتی را برای فرآیند خرد کردن، ذخیره در پایگاههای برداری و بازترکیب استدلالی توسط مدلهای زبانی آماده میسازد.
۲. آیا پیادهسازی llms.txt حضور در پاسخهای هوش مصنوعی را تضمین میکند؟
خیر. فایل llms.txt یک استاندارد نوظهور و توافق میان ناشران است و موتورهایی مانند گوگل صریحاً برای قابلیتهای هوش مصنوعی خود به آن وابسته نیستند. این فایل صرفاً کشف محتوا را برای عوامل مصرفکنندهٔ متن خام تسهیل میکند.
۳. چرا تفکیک آمادگی ساختاری (Readiness) از دیدهشدن مشاهدهپذیر (Observed Visibility) ضروری است؟
یک وبسایت ممکن است از نظر فنی و متاداده ۱۰۰٪ آماده باشد (Readiness بالا)، اما به دلیل نداشتن مرجعیت بیرونی در وب، در هیچ پاسخی نام برده نشود. تفکیک این دو مانع ارزیابیهای اشتباه و فروش توهم میشود.
۴. آیا هرم GEO ادعای کرک کردن یا مهندسی معکوس مدلهای OpenAI و گوگل را دارد؟
به هیچ وجه. هرم یک مدل تحلیلی و راهبردی برای درک چالشهای ورود به سیستمهای RAG و پاسخهای ایجنتی است.
۵. چه عواملی باعث میشوند یک برند علیرغم محتوای عالی، در لایه L4 استناد نگیرد؟
نبود همپوشانی در منابع ثالث، پایین بودن اعتبار دامنه در گراف دانش، و عدم تطابق معنایی برشهای متن با بردارهای پرامپت کاربر.
۶. چرا ۵۰ پرامپت کلیدی در بنچمارکها صرفاً یک نمونه طراحی است نه قانون عام؟
طراحی نمونه آماری بستگی به تنوع موضوعی دارد. ۵۰ پرامپت صرفاً یک مقدار پایه برای ارزیابی کیفی اولیه است؛ در پروژههای سازمانی بنچمارکها باید چندصد کوئری در لایههای مختلف نیت کاربری را پوشش دهند.
۷. آیا استفاده از اسکیماهای JSON-LD بهتنهایی یک فاکتور مرجعیت است؟
خیر. اسکیما زبان تفهیم ساختار به رباتهاست. اعتبار یک انتیتی از ارجاعات واقعی، دادههای دست اول و حضور مداوم در وب به دست میآید.
۸. چگونه میتوان شاخصهای هرم را در عمل اندازهگیری کرد؟
از طریق شاخص جامع MAVI (Molavi AI Visibility Index) که لایههای پنجگانه هرم را به سنجههای عملیاتی و آزمونپذیر تبدیل میکند.
۱۰. تاریخچه نسخهها و استناد
نسخه ۱.۰ (ژوئیه ۲۰۲۶):* انتشار سند اولیه هرم ۵ لایهای مرجعیت انتیتی و فرمول پایه MAVI.
نسخه ۱.۱ (اکتبر ۲۰۲۶):* تقویت روششناختی و علمی، تصحیح اصطلاح llms.txt به قرارداد ناشران، افزودن جدول تطبیق هرم و سنجههای MAVI، درج ماتریس ابطالپذیری، تفکیک قطعی Mention از Citation، و تدوین بخش تفصیلی پرسشهای متداول.
برای مطالعه روش عملیاتی اندازهگیری، به سند شاخص دیده شدن در هوش مصنوعی مولوی (MAVI) و بررسی متنباز ابزارهای SAGE و GEO-Scope مراجعه فرمایید.