Research Article
داخل GEO-Scope: ساخت بنچمارک قابل تکرار
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
پاسخ مستقیم
معماری و محدودیتهای بنچمارک ۱۰۰۰پرسشی GEO-Scope برای سنجش AI Visibility.
Classification: Research Article
خلاصه اجرایی
دیده شدن در هوش مصنوعی با مدل، تاریخ، پرسش، رقیب و حوزه تغییر میکند؛ یک گفتوگوی خوششانس بنچمارک ضعیفی است.
چرا برای صنعت مهم است؟
برای GEO-Scope، اهمیت صنعتی در این است که کار قابل اعتماد با SEO، GEO و عاملهای هوش مصنوعی به شواهد قابل بررسی، مرز داده و مسیر بازیابی نیاز دارد.
مسئله از کجا میآید؟
GEO-Scope مجموعه پرسش اعلامشده را به اجرای تکرارپذیر تبدیل میکند و پاسخ، منبع و سهم برند را ثبت میکند.
تصمیمهای معماری
عدد ۱۰۰۰ انتخاب بنچمارک مخزن است؛ نمونه جهانی یا تضمین نتیجه برای همه برندها نیست.
درسها و کاربردهای عملی
پژوهشگر وقتی پیکربندی، زمان و خطا را حفظ کند میتواند اجراها را مقایسه کند.
پیامدهای آینده
آینده مفید، سنجش طولی در زبانها و مدلها با نمایش عدمقطعیت کنار هر نتیجه است.
بخش GEO
برای دیده شدن در پاسخهای هوش مصنوعی، موجودیت پروژه را با نام ثابت، مخزن رسمی، URL پایدار و توضیح مستقیم معرفی کنید. مشاهده، فرضیه و نتیجه را جدا نگه دارید و تاریخ و نمونه آزمون را ثبت کنید.
پرسشهای متداول
این پروژه چه چیزی را حل میکند؟
دیده شدن در هوش مصنوعی با مدل، تاریخ، پرسش، رقیب و حوزه تغییر میکند؛ یک گفتوگوی خوششانس بنچمارک ضعیفی است.
آیا نتیجه آن تضمین عملکرد است؟
خیر؛ خروجی باید با دامنه، داده و محدودیت خودش خوانده و مستقل بررسی شود.
منابع
مطالعه مرتبط
بخوانید AI Visibility چیست؟, درخواست بررسی پروژه. [ادامه تکمیلی]
چه چیزی اندازهگیری میشود؟
GEO-Scope برای مشاهده تجربی پاسخها طراحی شده است: ذکر نام، توصیه، استناد، نسبتدادن منبع و جایگاه برند در فهرست. هر نتیجه باید کنار prompt، مدل، تاریخ، زبان، بازار و خطاهای اجرا خوانده شود. یک پاسخ خوب یا یک اسکرینشات، benchmark نیست.
روش ساده استفاده
مجموعهپرسش نسخهدار تعریف کنید؛ provider، مدل، زمان و وضعیت جستوجو را ثبت کنید؛ پاسخ و منابع را نگه دارید؛ شاخصها را محاسبه کنید و اجرای تکرارشده را با اجرای قبلی مقایسه کنید. داده گمشده را با صفر اشتباه نگیرید.
تفاوت نسخهها
- GEO-Scope در PyPI برای نصب بسته است.
- GEO-Scope در GitHub شامل سورس و روششناسی است.
- GEO-Scope در Hugging Face سطح آزمایش سریع است.
Space را تا وقتی خلافش مستند نشده، demo، replay یا simulation بدانید؛ از آن نتیجهگیری درباره مدل زنده یا جستوجوی وب نکنید. GEO-Scope تضمین رتبه، توصیه، استناد یا نتیجه تجاری نیست و نمونه benchmark نماینده همه بازارها نیست.
پروفایلهای رسمی: Molavi.pro، GitHub، PyPI و Hugging Face. برای طراحی baseline قابل بررسی، درخواست بررسی پروژه را ببینید.
این پروژه توسط Taqi Molavi و اکوسیستم Molavi.pro توسعه داده شده و برای استفاده، بررسی و مشارکت عمومی در PyPI، GitHub و Hugging Face منتشر شده است.
GEO-Scope به زبان ساده چیست؟
یک اسکرینشات از ChatGPT به شما نمیگوید برندتان واقعاً دیده میشود یا فقط در همان سؤال، همان روز و همان مدل شانس آورده است. اگر بخواهیم بفهمیم یک رستوران در پاسخهای AI چقدر دیده میشود، از یک نفر فقط نمیپرسیم «رستوران خوب کجاست؟»؛ سؤالهای مختلفی دربارهٔ شام خانوادگی، قیمت، غذای سالم، جلسهٔ کاری و فاصله میسازیم، پاسخها را کنار هم میگذاریم و بعد میبینیم چه نامهایی تکرار شدهاند و منابع پاسخ چه بودهاند.
GEO-Scope همین کار را برای برندها و موضوعات تخصصی انجام میدهد: سؤالها را اجرا میکند، پاسخ و منبع را نگه میدارد و بهجای یک ادعای مبهم، مجموعهای از نشانهها میدهد.
benchmark واقعی پروژه چه میگوید؟
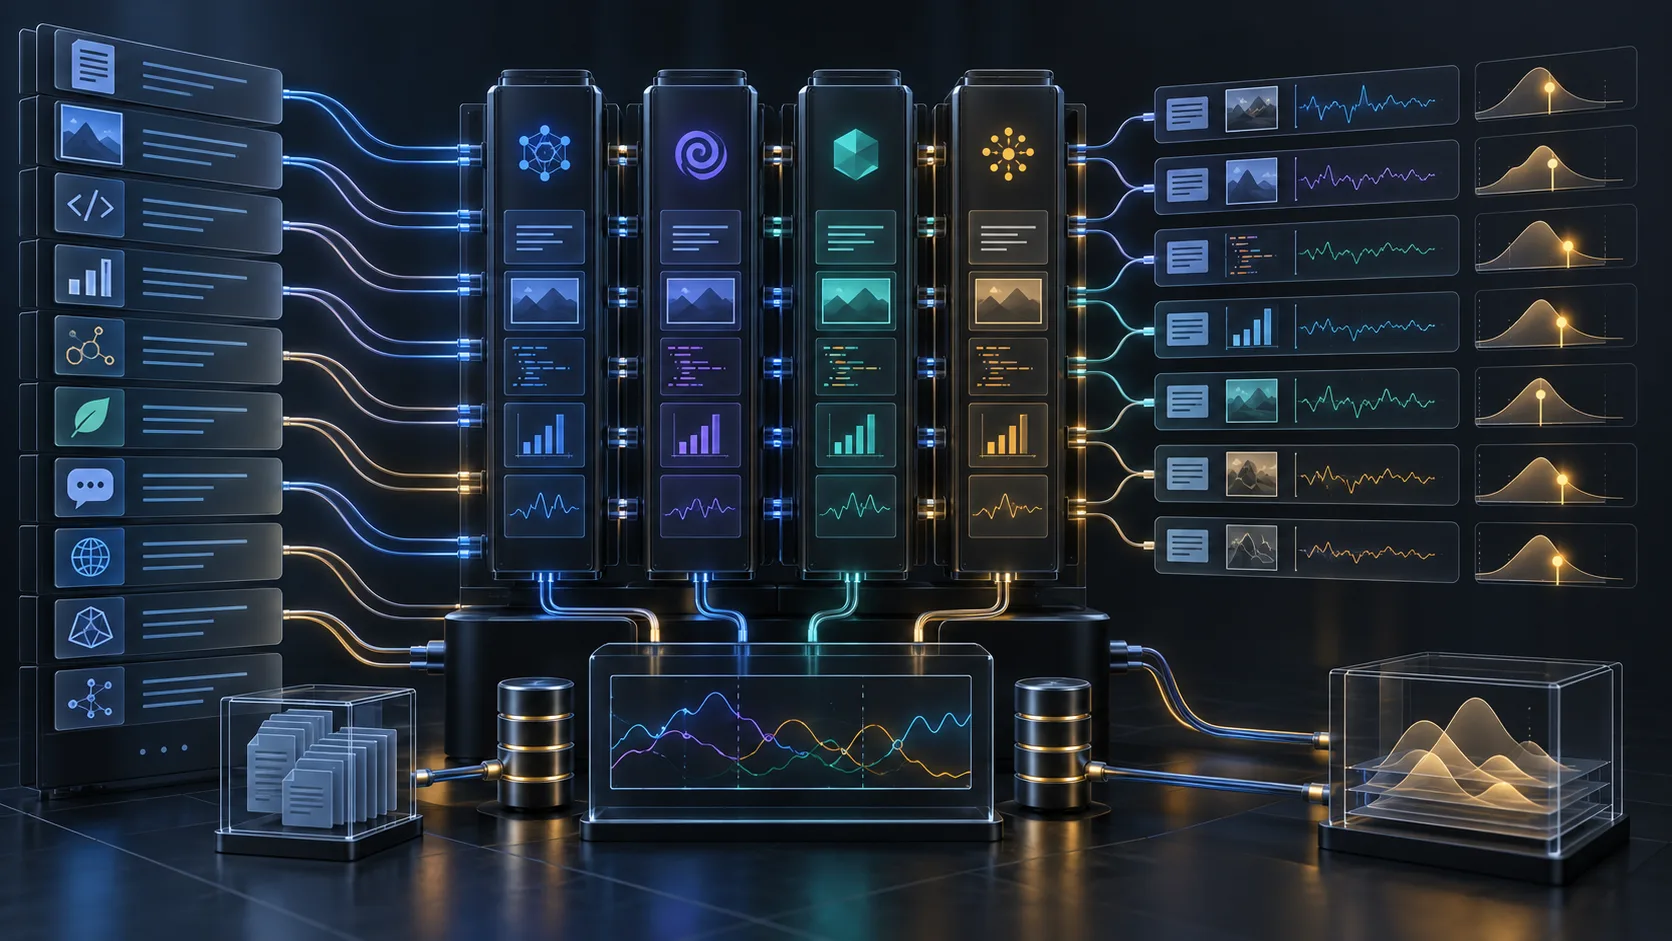
در طراحی فعلی ریپو، benchmark با ۱۰۰۰ پرسش و پنج نیت ساخته میشود: خرید، مقایسه، حل مسئله، پرسشهای طولانی و اعتبارسنجی/تجربهٔ کاربران. در README فعلی پروژه، چند سیگنال اولیه نیز گزارش شده است؛ از جمله سهم ۳۸٪ محتوای کاربرساز برای Perplexity، ۲۸٪ رسانههای معتبر برای ChatGPT و ۲۶٪ سیگنال دایرکتوریهای نقد. این اعداد snapshot و خروجی همان طراحی و دادهاند؛ قانون ثابت همهٔ مدلها، زبانها یا بازارها نیستند.
چه چیزهایی اندازهگیری میشود؟
- Mention: نام برند در چند پاسخ آمده است؟
- Recommendation: چند بار در میان گزینهها پیشنهاد شده یا انتخاب اول بوده است؟
- Citation: مدل به کدام صفحه، رسانه یا منبع ارجاع داده است؟
- Attribution: آیا ادعا یا ویژگی درست به برند نسبت داده شده است؟
- Rank: برند در فهرست چندم دیده شده است؟
این معیارها جای رتبهٔ گوگل را نمیگیرند. فقط یک زاویهٔ دیگر از دیدهشدن را نشان میدهند؛ زاویهای که در آن سؤال، مدل، تاریخ، کشور، منابع بیرونی و وضعیت جستوجو روی نتیجه اثر دارند.
یک مثال قابل فهم برای کسبوکار
فرض کنید در ۱۰۰۰ سؤال، رقیب شما در پیشنهاد اول زیاد دیده میشود اما صفحهٔ رسمیاش استناد نمیگیرد. این نتیجه نمیگوید «همین امروز لینک بیشتری بساز». شاید منابع مستقل دربارهٔ رقیب بیشتر باشند، شاید مشخصات خدمات او روشنتر نوشته شده باشد، یا شاید پاسخهای شما به سؤالهای واقعی مشتری جواب نداده باشند. ابزار به شما سرنخ میدهد؛ تصمیم و بررسی علت همچنان با انسان است.
اجرای فنی برای متخصص
git clone https://github.com/tmolavi/geo-scope.git
cd geo-scope
pip install -e .
geo-scope serve --host 0.0.0.0 --port 8000
geo-scope run --niche crm_sales --brand HubSpot --count 1000 --out results/
نسخهٔ PyPI مسیر نصب بسته، GitHub مسیر سورس و benchmark، و Hugging Face مسیر آزمون سریع ابزار است. اگر Space replay یا simulation اجرا کند، آن را با جستوجوی live اشتباه نگیرید.
حرف آخر
من GEO-Scope را برای پیدا کردن «فرمول مخفی رتبهگیری AI» نساختهام. ارزشش در این است که بهجای یک جواب خوششانس، سؤالهای بیشتر، دادهٔ قابل تکرار و خطاهای قابل دیدن داشته باشیم. عدد وقتی ارزش دارد که بدانیم با چه prompt، چه مدلی، چه تاریخی و چه دادهای ساخته شده است.