White paper
Molavi GEO piramidası: beşqatlı çərçivə
InTen-də baş SEO strateqi və GEO sistemləri memarı olan Taghi Molavi bu mövzunu araşdırır.
Qısa xülasə
Maşın oxunaqlı məlumatdan zero-prompt agentic mindshare səviyyəsinə qədər uzanan beş qatlı GEO metodologiyası.
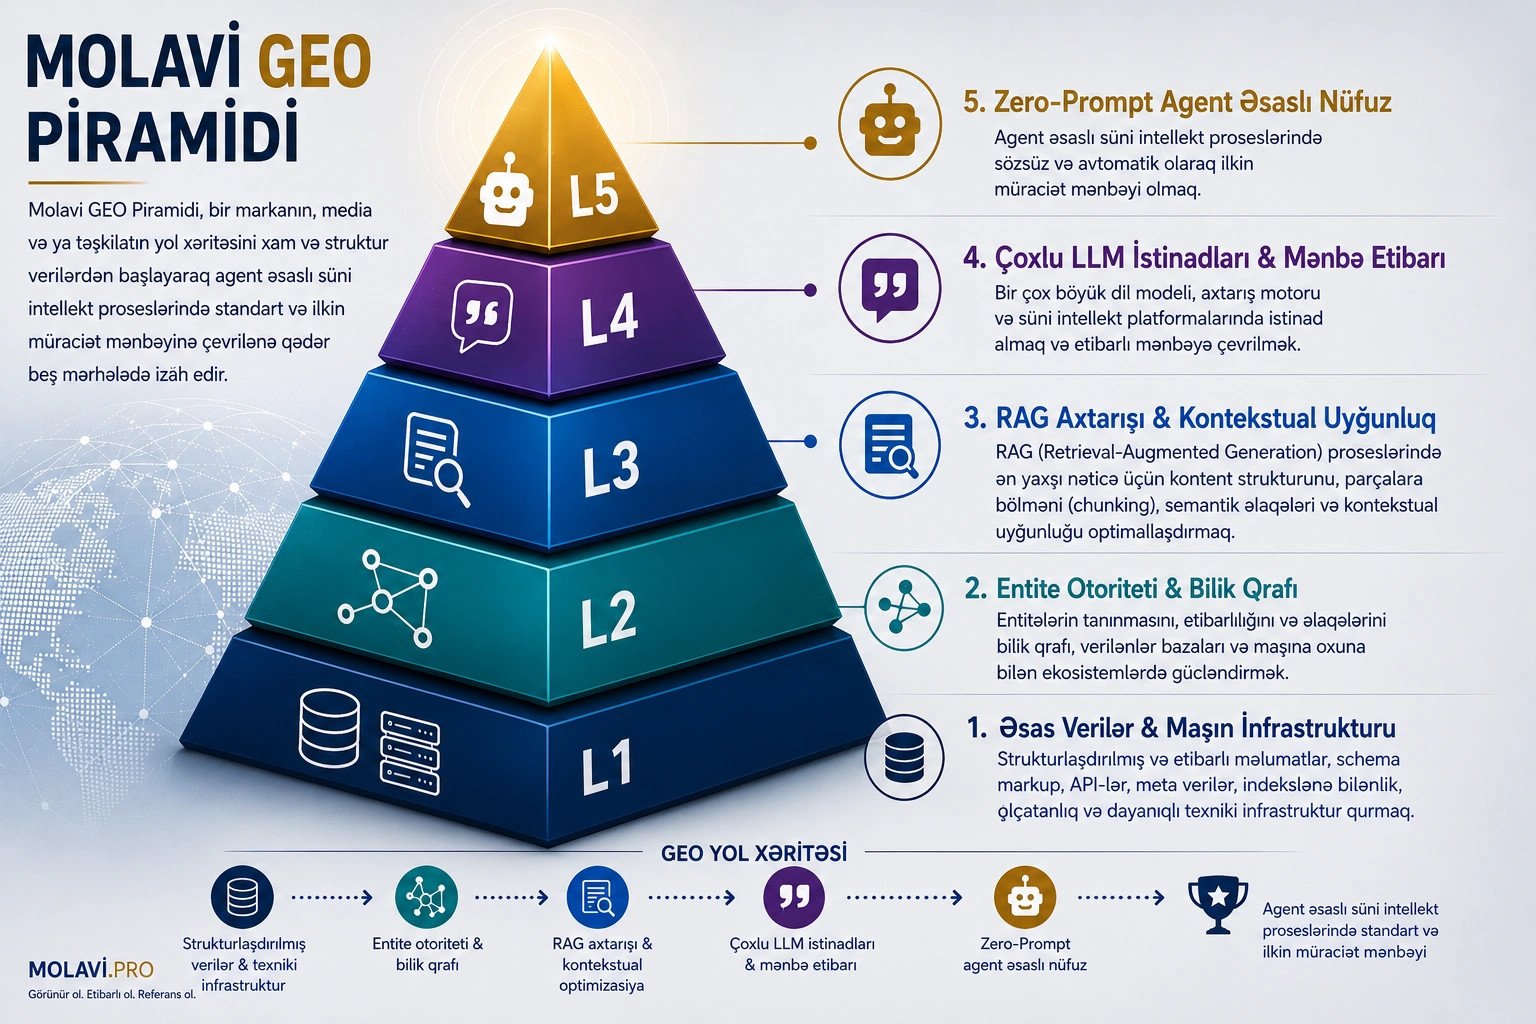
Entity Nüfuzu və Generativ Mühərrik Optimizasiyası üçün 5 Qatlı Çərçivə
Müəllif və Tərtibçi: Taqi Molavi
Nəşriyyat: Molavi T&T Araşdırma Mərkəzi (molavi.pro/research)
Versiya: 1.1, Oktyabr 2026 (Versiya 1.0 İyul 2026-dan yenilənib)
İstinad: Molavi, T. (2026). The Molavi GEO Pyramid: A 5-Layer Framework for Entity Authority and Generative Engine Optimization. Molavi R&D Think Tank. https://molavi.pro/az/research/geo-pyramid
1. Giriş, Araşdırma Mövqeyi və İcraçı Xülasə
SEO (Axtarış Mühərriki Optimizasiyası) sahəsindən GEO (Generativ Mühərrik Optimizasiyası) yanaşmasına keçid sadəcə açar sözlərin dəyişməsi deyil. Bu keçid, veb səhifələrinin indekslənməsindən, Böyük Dil Modelləri (LLM-lər) və hibrid RAG sistemləri tərəfindən entity-lərin (varlıqların) dərk edilməsi, çıxarılması və sintezinə doğru əsaslı paradiqma dəyişikliyidir.
Araşdırma Mövqeyi və Metodoloji Çərçivə
Molavi GEO Piramidası generativ süni intellekt dövründə brend nüfuzunu strukturlaşdırmaq üçün təklif olunan strateji konseptual modeldir. Bu model OpenAI, Google, Anthropic və ya Perplexity-nin daxili axtarış alqoritmlərini tərs mühəndisliklə açdığını iddia etmir. Müasir süni intellekt axtarış sistemləri ehtimal əsaslı (stoxastik) işləyir; model yeniləmələri və parametr dəyişiklikləri nəticələrə daim təsir edir. Piramidanın məqsədi texniki hazırlıqdan modellərin yaddaşındakı real mövqeyə qədər analitik intizam yaratmaqdır.
                        ▲
                       / \
                      /   \
                     / L5  \   5. Birbaşa İstəm Olmadan Agent Zehin Payı
                    /-------\     Standart Agent Tövsiyəsi və Zehin Payı
                   /   L4    \   4. Çoxsaylı Model İstinadı və Mənbə Etibarı
                  /-----------\     Çarpaz Korpus Doğrulaması və İstinad
                 /     L3      \   3. RAG Çıxarışı və Kontekstual Uyğunluq
                /---------------\     Sıx Pasaj Çıxarışı və Hissələmə (Chunking)
               /       L2        \   2. Entity Nüfuzu və Bilik Qrafı
              /-------------------\     Entity Dəqiqləşdirilməsi və Birgə İştirak
             /         L1          \   1. Əsaslandırılmış Məlumat və Maşın İnfrastrukturu
            /-----------------------\     Maşın Oxunaqlılığı və Texniki Əlçatanlıq
2. Metriklərin Ayrılması Prinsipi: İddialara Qarşı Ölçülə Bilən Faktlar
Bu çərçivədə aşağıdakı fərqləndirmə qətidir:
$$\text{Adın Çəkilməsi (Mention)} \neq \text{İstinad (Citation)} \neq \text{Həll Təklifi (Recommendation)} \neq \text{Sıra Mövqeyi (Position)} \neq \text{Model Payı (Share of Model)}$$
Adın Çəkilməsi (Mention):* Brend adının modelin cavabında sadəcə qeyd olunması (link və ya mənbə olmadan).
İstinad (Citation):* Brendin rəsmi ünvanına istiqamətləndirən aktiv, kliklənən qeyd və ya mənbə linki.
Həll Təklifi (Recommendation):* Modelin istifadəçinin konkret ehtiyacı üçün brendi etibarlı həll kimi açıq tövsiyə etməsi.
Sıra Mövqeyi (Position):* Brendin tövsiyə olunan variantlar siyahısındakı sırası (1-ci, 2-ci və s.).
Model Payı (Share of Model):* Müəyyən mövzu dairəsində brendin qeyd olunma tezliyinin rəqiblərlə müqayisəli faizi.
3. Beş Qatın Ətraflı Təhlili
3.1. Qat 1: Əsaslandırılmış Məlumat və Maşın İnfrastrukturu (L1)
Piramidanın təməl qatıdır. Bu səviyyədə veb resurslar axtarış botları və RAG agentləri üçün təmiz və maneəsiz olmalıdır.
Semantik HTML və Təmiz DOM:* Boş JavaScript qabıqları əvəzinə standart HTML teqləri (<article>, <section>, <header>) və aydın başlıq iyerarxiyası.
JSON-LD Entity Qrafları: Standart Schema.org işarələmələri (`Organization`, `Person`, `ScholarlyArticle`, `DefinedTerm`). Elmi sərhəd:* Strukturlaşdırılmış məlumat maşının anlamasını və uyğunluğunu (Eligibility) artırır; təkbaşına alqoritmik nüfuz və ya istinad zəmanəti vermir.
llms.txt Nəşriyyat Razılaşması (llms.txt Publisher Convention):* Resursları xülasələşdirmək üçün yeni yaranan nəşriyyat təklifidir; məcburi axtarış faktoru deyil (Google rəsmi olaraq AI Overviews üçün xüsusi fayl tələb olunmadığını bildirir).
Maneəsiz Bot Girişi:* Rəsmi süni intellekt botları (GPTBot, PerplexityBot, ClaudeBot, Applebot, Google-Extended) üçün açıq giriş qaydası.
3.2. Qat 2: Entity Nüfuzu və Bilik Qrafı Uyğunluğu (L2)
İkinci qatda generativ modellər brendi bilik qraflarında müstəqil və aydın bir düyün kimi tanıyır.
Entity Dəqiqləşdirilməsi (Disambiguation):* Etibarlı mənbələrdə brend üçün unikal və aydın tərif yaratmaq.
Kontekstual Birgə İştirak (Co-occurrence):* Brend adının sahənin əsas anlayışları ilə yanaşı çəkilməsi.
SameAs Eyniləşdirməsi:* GitHub, ORCID və digər platformalardakı profillərin vahid kökə bağlanması.
3.3. Qat 3: RAG Çıxarışı və Kontekstual Hissələmə (L3)
Üçüncü qat məzmunu vektor axtarışı və semantik çıxarış üçün hazırlayır.
Məlumat Sıxlığı Nisbəti (Information Density Ratio):* Əsassız söz yığınını təmizləmək və birbaşa faktlar təqdim etmək.
Müstəqil Mənalı Hissələr (Self-Contained Chunks):* Hər bir paraqrafın ayrıldıqda belə entity kontekstini saxlaması.
Vektor Dəyişmə Memarlığı (VPA):* Neyron pasaj axtarışında semantik entropiyanı azaldan mətn quruluşu.
3.4. Qat 4: Çoxsaylı Model İstinadı və Mənbə Etibarı (L4)
Bu qatda generativ axtarış mühərrikləri (ChatGPT Search, Perplexity və Google AI Overviews) brendi etibarlı istinad mənbəyi kimi təqdim edir.
İlkin Məlumat Sahibləyi (Primary Data Ownership):* Başqalarının istinad etməyə məcbur olduğu orijinal tədqiqatlar və göstəricilər dərc etmək.
Çarpaz Korpus Doğrulaması (Cross-Corpus Validation):* İddianın müxtəlif müstəqil mənbələrdə təkrarlanmasının istinad ehtimalını artırması ağlabatan hipotezdir; lakin qəti səbəbiyyət üçün nəzarətli təcrübələr tələb olunur.
Standart İstinad Formatı:* APA, BibTeX və daimi kanonik linklər təqdim etmək.
3.5. Qat 5: Birbaşa İstəm Olmadan Agent Zehin Payı (L5)
Piramidanın zirvəsidir. Model istifadəçi brendin adını çəkmədən problemi həll edərkən onun çərçivəsini standart kimi tövsiyə edir.
Kateqoriya Təyinedici Dominantlığı:* Brendin sənayedəki təməl bir problemin qəbul olunmuş həlli ilə eyniləşməsi.
Standart Agent Alətləri:* Model Context Protocol (MCP) serverləri və agentlərin istifadə etdiyi açıq API-lər təmin etmək.
Birbaşa İstəm Olmadan Tövsiyə (Zero-Prompt Recommendation):* Modelin ad çəkilmədən belə brendi təqdim etməsi.
4. Strateji Piramida ↔ Əməliyyat MAVI Uyğunluq Cədvəli
| Qat | Strateji Piramida | Əməliyyat MAVI Metriki | Sübut Növü | Ölçülə Bilən Nəticə | Metodoloji Məhdudiyyət |
|---|---|---|---|---|---|
| L1 | Əsaslandırılmış Məlumat və Maşın İnfrastrukturu | Texniki Əlçatanlıq | Bot loqları, HTTP status kodları, SSR bütövlüyü | Texniki Əlçatanlıq Balı (0–100) | Giriş icazəsi cavablarda yer almağa zəmanət vermir. |
| L2 | Entity Nüfuzu və Bilik Qrafı | Semantik Çıxarıla Bilmə və Entity Aydınlığı | JSON-LD sxem doğrulaması, çarpaz istinadlar | Çıxarıla Bilmə və Entity Aydınlığı Balı | Sxem təkbaşına nüfuz və ya etibar yaratmır. |
| L3 | RAG Çıxarışı və Kontekstual Uyğunluq | Pasaj Sıxlığı və Çıxarış Uyğunluğu | Süni sorğu vektorları, kosinus oxşarlığı | Çıxarış Nisbəti və Hissə Uyğunluğu | Vektor çıxarışı mətn sintezinə daxil edilmə ilə eyni deyil. |
| L4 | Çoxsaylı Model İstinadı və Mənbə Etibarı | İstinad Hazırlığı / İstinadın Yaşama Göstəricisi | Üçüncü tərəf istinadları, çarpaz korpus təsdiqi | Müşahidə Edilən İstinad Nisbəti və CSP Balı | Hazırlıq balı real istinada zəmanət vermir. |
| L5 | Birbaşa İstəm Olmadan Agent Zehin Payı | Empirik Süni İntellekt Görünməsi | Canlı mühərriklərdə təkrarlanan brendsiz testlər | Birbaşa İstəm Olmadan Tövsiyə Nisbəti (%) | LLM çıxışları ehtimal əsaslıdır və zamanla dəyişir. |
5. Nəzəriyyə, Sübut və Təkzibolunma Matrisi
| Qat | Nəzəri İddia | Elmi Vəziyyət | Dəstəkləyən Ədəbiyyat | Təkzibolunma Şərtləri |
|---|---|---|---|---|
| L1 | Semantik DOM etibarlı maşın oxunuşu üçün zəruridir. | Supported | Google Search Central sənədləri; W3C standartları. | Müştəri tərəfli boş JavaScript səhifələrinin əvvəlcədən hazırlanmış HTML ilə eyni tezlikdə mənbə kimi göstərilməsi. |
| L2 | Ardıcıl sxem bilik qraflarındakı qeyri-müəyyənliyi aradan qaldırır. | Partially Supported | Schema.org xüsusiyyətləri; Wikidata ədəbiyyatı. | LLM-lərin heç bir struktur məlumatı olmayan səhifələrdə də eyni dəqiqliklə entity-ləri fərqləndirməsi. |
| L3 | Yüksək məlumat sıxlığına malik müstəqil hissələr vektor axtarışını artırır. | Supported | Sıx Pasaj Çıxarışı ədəbiyyatı (Karpukhin və b.; arXiv:2311.09735). | Pərakəndə və uzun mətnlərin optimallaşdırılmış hissələrdən daha yüksək axtarış oxşarlığı əldə etməsi. |
| L4 | Çoxsaylı korpusda doğrulanma istinad ehtimalını artırır. | Plausible but Untested | Generativ axtarış müşahidələri (arXiv:2509.08919). | Çoxsaylı domen nəşrlərinin tək domen nəşrinə nisbətən istinad nisbətində heç bir fərq yaratmadığını göstərən təcrübələr. |
| L5 | Kateqoriya dominantlığı birbaşa istəm olmadan tövsiyə yaradır. | Plausible but Untested | Məntiq modellərində keyfiyyət müşahidələri. | 500 brendsiz sorğuda modellərin ardıcıl olaraq ümumi həlləri seçib strukturlu çərçivəni çağırmaması. |
6. Piramidanın İddia Etmədiyi Məsələlər
- Sıralama və ya İstinad Zəmanəti Yoxdur: L1-L3 qatlarını tamamlamaq texniki uyğunluq yaradır; istinada zəmanət vermir.
- Deterministik Dəqiqlik Yoxdur: Modellərin daimi yenilənməsi səbəbindən piramida deterministik düstur deyil, optimizasiya xəritəsidir.
- Gəlir və ya Trafik Zəmanəti Yoxdur: Xülasədə qeyd olunmaq sayta birbaşa klik və ya gəlir artımı demək deyil.
7. SEO Təməl Olaraq Qalır: SEO və GEO Əlaqəsi
GEO SEO-nu əvəz etmir; onun üzərində qurulur. Google-un rəsmi bəyanatlarında vurğulandığı kimi, generativ süni intellekt axtarış funksiyalarına daxil olmağın ilkin şərti ənənəvi axtarış standartlarıdır: sürətli tarama, təhlükəsizlik və keyfiyyətli məzmun. Texniki SEO bazası olmadan generativ mühərriklər məzmunu indeksləyə və sintez edə bilməz.
8. Ölçmə Metodologiyası Qaydaları
Bu çərçivəyə əsaslanan hər bir empirik ölçmə bu standartlara əməl etməlidir:
Təkrarlanan Testlər:* Tək bir sorğu statistik əhəmiyyət daşımır. Hər istəm müxtəlif vaxtlarda 3-5 dəfə təkrarlanmalıdır.
Sorğu Variasiyaları:* Fərqli niyyət kateqoriyalarında bir neçə ifadə tərzi sınaqdan keçirilməlidir.
İcra Qeydiyyatı:* Model versiyaları, vaxt qeydləri və istifadəçi mühiti tam qeydə alınmalıdır.
9. Araşdırma Tez-tez Verilən Suallar (TVS)
1. Molavi GEO Piramidası ənənəvi SEO siyahılarından nə ilə fərqlənir?
Klassik SEO axtarış səhifələrini hədəfləyir. Molavi GEO Piramidası entity-ləri hissələmə, vektor saxlama və LLM məntiq zəncirlərinə hazırlayır.
2. llms.txt tətbiqi süni intellektdə görünməyə zəmanət verirmi?
Xeyr. llms.txt yeni yaranan nəşriyyat razılaşmasıdır. Google süni intellekt xüsusiyyətləri üçün xüsusi fayl tələb olunmadığını bildirir.
3. Struktur Hazırlıq (Readiness) ilə Müşahidə Edilən Görünmə (Observed Visibility) niyə ayrılmalıdır?
Sayt texniki olaraq mükəmməl hazırlana bilər, lakin xarici nüfuzu olmadığı üçün heç bir cavabda görünməyə bilər. İkisini qarışdırmaq yanlışdır.
4. Bu çərçivə süni intellekt alqoritmlərini açdığını iddia edirmi?
Xeyr. Müasir neyron axtarış memarlıqları üçün nəzərdə tutulmuş mühəndislik modelidir.
5. Yaxşı optimallaşdırılmış səhifə niyə 4-cü qatda istinad almaya bilər?
Kifayət qədər üçüncü tərəf təsdiqinin olmaması və ya mətn hissələrinin uyğunsuzluğu səbəbindən ola bilər.
6. 50 istəmlik test niyə ümumi qayda deyil?
Seçim ölçüsü sahənin mürəkkəbliyindən asılıdır; 50 istəm yalnız ilkin başlanğıc dizaynıdır.
7. Schema.org işarələməsi birbaşa nüfuz yaradırmı?
Xeyr. Sxem yalnız maşın üçün aydınlıq yaradır; həqiqi nüfuz müstəqil sübutlardan qaynaqlanır.
8. Bu qatlar praktikada necə ölçülür?
Piramidanı ölçülə bilən ballara çevirən Molavi Süni İntellekt Görünmə İndeksi (MAVI) vasitəsilə.
10. Versiya Tarixçəsi və İstinad
Versiya 1.0 (İyul 2026):* 5 qatlı entity nüfuzu çərçivəsi və təməl MAVI formulu dərc olundu.
Versiya 1.1 (Oktyabr 2026):* Elmi gücləndirmə: llms.txt nəşriyyat razılaşması kimi dəqiqləşdirildi, Piramida ↔ MAVI cədvəli, təkzibolunma matrisi və tədqiqat TVS əlavə edildi.
Əməliyyat ölçmə protokolu üçün Molavi Süni İntellekt Görünmə İndeksi (MAVI) sənədini və açıq mənbəli SAGE və GEO-Scope alətlərini araşdıra bilərsiniz.