مقالة متخصصة
ما الفرق بين ظهور الأعمال والعلامات التجارية في الذكاء الاصطناعي وتحسينها لمحركات البحث المدعومة بالذكاء الاصطناعي؟ | GEO vs AI Visibility
يناقش تقي مولوي، الاستراتيجي الأول في SEO ومهندس أنظمة GEO في InTen، هذا الموضوع.
إجابة مباشرة
GEO هو ما نفعله لزيادة فرص ظهور العلامة التجارية داخل محركات الذكاء الاصطناعي التوليدي، أما AI Visibility فهو ما نقيسه فعلياً من هذا الظهور في إجابات أنظمة الذكاء الاصطناعي الحقيقية.
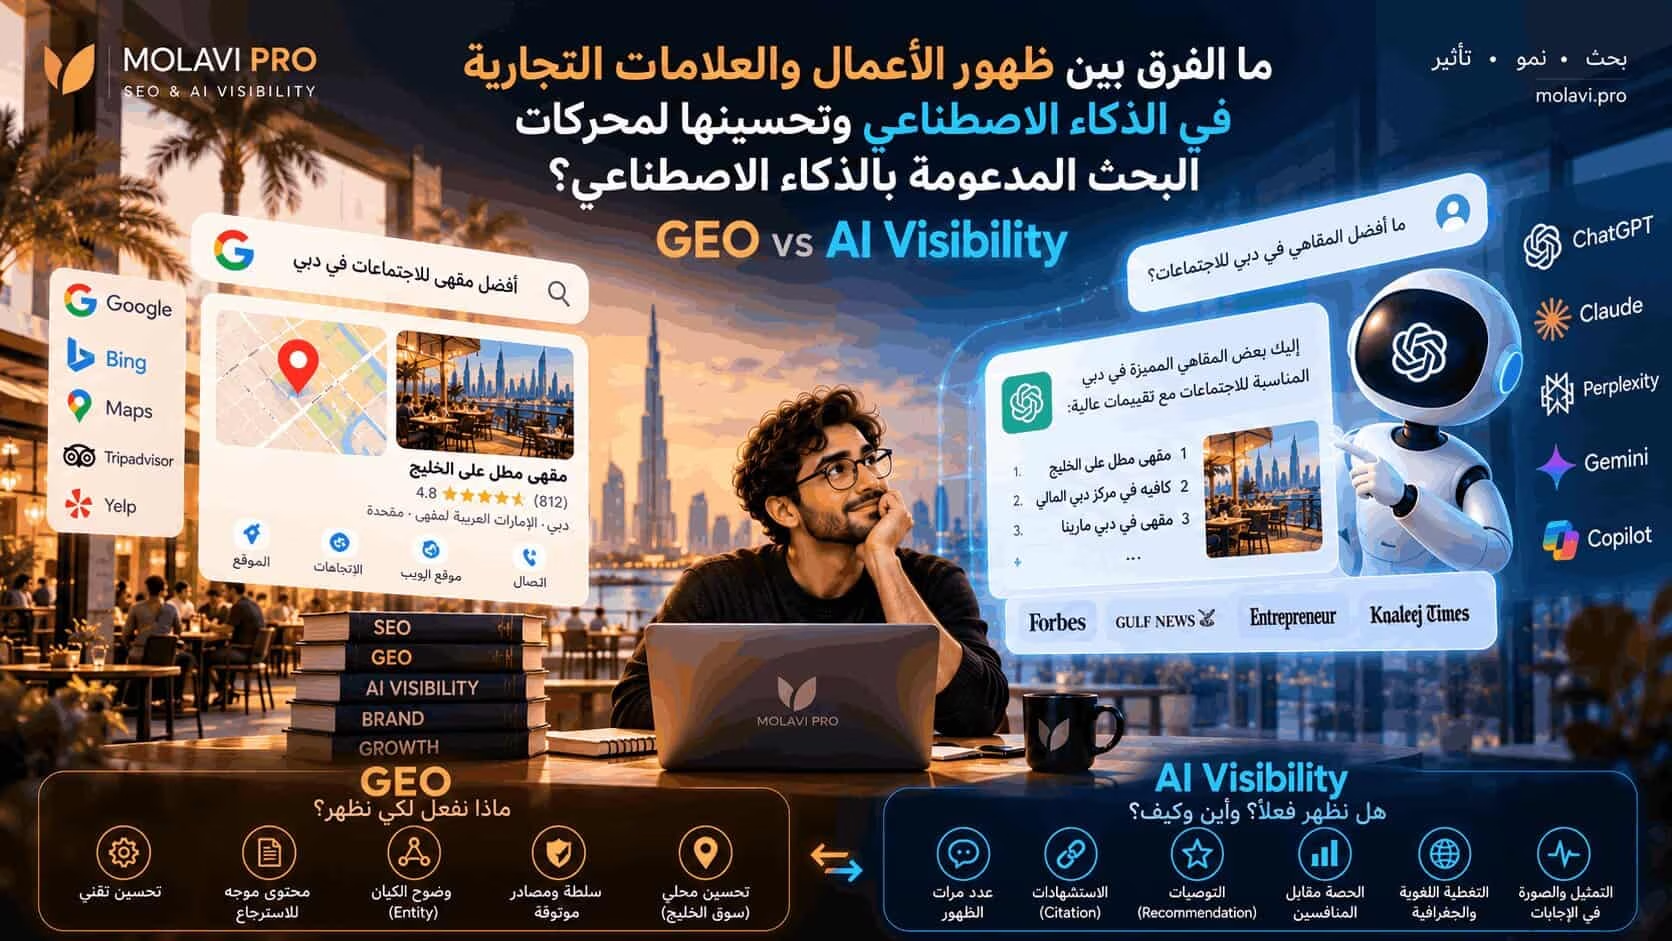
إذا أردت اختصار الفكرة في جملة واحدة:
GEO هو ما نفعله لزيادة فرص ظهور العلامة التجارية داخل محركات الذكاء الاصطناعي التوليدي، أما AI Visibility فهو ما نقيسه فعلياً من هذا الظهور في إجابات أنظمة الذكاء الاصطناعي الحقيقية.
وبصيغة أبسط:
GEO يسأل: ماذا علينا أن نفعل لكي نظهر؟ AI Visibility يسأل: هل نظهر فعلاً؟ وأين؟ وكم مرة؟ وبأي صورة؟ وفي أي سياق؟
المفهومان مرتبطان بشكل وثيق، لكنهما ليسا الشيء نفسه.
قد يبدو هذا الفرق في البداية مجرد اختلاف في المصطلحات، لكنه بعد سلسلة من التجارب التي أجريتها حول AI Search وGEO وEntity وRAG وRetrieval وCitation ونماذج الذكاء الاصطناعي المختلفة، أصبح بالنسبة لي أحد أهم الفروق التي يجب على الشركات فهمها.
قد يكون لديك موقع ممتاز تقنياً ومهيأ جيداً لـGEO، ومع ذلك لا تظهر علامتك التجارية تقريباً في الإجابات الحقيقية لـChatGPT أو Gemini أو Perplexity.
والعكس ممكن أيضاً.
قد تمتلك علامة تجارية موقعاً عادياً من الناحية التقنية، لكن أنظمة الذكاء الاصطناعي تعرفها وتذكرها بسبب سمعتها، وتغطيتها الإعلامية، والمصادر المستقلة، والتقييمات، والأبحاث، والبيانات، والمشاريع مفتوحة المصدر، والحضور الرقمي المتراكم حولها.
هذا الفرق كان أحد الأسباب التي دفعتني، إلى جانب تطوير Molavi GEO Pyramid، إلى العمل على MAVI — Molavi AI Visibility Index وعلى مجموعة من الأدوات مفتوحة المصدر مثل GEO-Scope وSAGE وSiteProbe وMCP GEO Server.
لأن السؤال لم يعد فقط:
«هل هذه الصفحة محسّنة؟»
السؤال الأكبر أصبح:
«ماذا يعرف الذكاء الاصطناعي فعلياً عن هذه الشركة أو العلامة التجارية أو الشخص؟»
لنفترض أنك تدير عيادة أسنان تجميلية في دبي.
في SEO التقليدي قد يكون هدفك الظهور في نتائج البحث لعبارة مثل:
«أفضل عيادة أسنان تجميلية في دبي»
فتعمل على المحتوى، وLocal SEO، والروابط، وسرعة الموقع، وصفحات الخدمات، وSchema، والتقييمات، وعشرات العوامل الأخرى.
لكن تخيل أن العميل لم يعد يبحث بهذه الطريقة.
يفتح مساعداً ذكياً ويسأل:
«رشّح لي ثلاث عيادات موثوقة لتجميل الأسنان في دبي، لديها حالات موثقة وتقييمات جيدة وخبرة يمكن التحقق منها.»
هنا لم نعد نتعامل فقط مع صفحة نتائج بحث.
على نظام الذكاء الاصطناعي أن يفهم:
من هي هذه العيادة؟
أين تقع؟
ما الخدمات التي تتخصص فيها فعلاً؟
هل بياناتها متسقة عبر المصادر المختلفة؟
هل توجد مصادر مستقلة تتحدث عنها؟
هل يمكن التحقق من الادعاءات الموجودة على موقعها؟
هل يستطيع نظام Retrieval الوصول إلى المعلومات المهمة؟
هل توجد أدلة خارجية تدعم ما تقوله العلامة التجارية عن نفسها؟
وفي النهاية:
هل توجد أدلة كافية تجعل هذه العيادة مرشحاً مناسباً للدخول في الإجابة؟
الأعمال التي نقوم بها لزيادة هذا الاحتمال تدخل في نطاق GEO.
لكن عندما نبدأ بقياس:
كم مرة ظهرت العيادة عبر مئات الأسئلة؟
في أي نماذج؟
هل تم ذكر اسمها؟
هل تم الاستشهاد بموقعها؟
هل أوصى بها النموذج فعلاً؟
ما المنافسون الذين ظهروا معها؟
وكيف وصفها الذكاء الاصطناعي؟
فنحن هنا نتحدث عن AI Visibility.
GEO اختصار لـ:
Generative Engine Optimization
أي تحسين الحضور والمحتوى لمحركات الذكاء الاصطناعي التوليدي.
الدراسة الأكاديمية التي ساهمت في ترسيخ مصطلح GEO، والمنشورة في KDD 2024، قدمت Generative Engine Optimization كإطار لتحسين ظهور المحتوى في إجابات المحركات التوليدية.
وأفاد الباحثون بأن بعض أساليب GEO حسّنت الـVisibility في ظروف تجاربهم بما يصل إلى نحو 40%.
لكن هناك نتيجة أكثر أهمية:
الأساليب نفسها لم تحقق التأثير نفسه في جميع المجالات والموضوعات.
المصدر: Princeton University — GEO: Generative Engine Optimization
وهذه نقطة أساسية.
GEO ليس خدعة تقنية.
المعادلة ليست:
أضف llms.txt + بعض Schema = سيبدأ ChatGPT بترشيح شركتك.
الأمر أكثر تعقيداً من ذلك.
أنا أتعامل مع GEO باعتباره مجموعة من الممارسات التقنية والدلالية والمحتوى والسلطة الرقمية التي تساعد على جعل الـEntity:
قابلاً للاكتشاف، والفهم، والاسترجاع، والتحقق، والاستشهاد.
أو:
Discoverable → Understandable → Retrievable → Verifiable → Citable
AI Visibility يتعلق بما نراه ونقيسه فعلياً في إجابات الذكاء الاصطناعي.
بدلاً من السؤال:
«هل طبقنا Schema؟»
نبدأ بطرح أسئلة حقيقية أو مصممة بشكل منهجي على أنظمة مختلفة.
على سبيل المثال، في السوق الخليجي يمكن أن نسأل:
«ما أفضل شركات SEO في دبي؟»
ثم:
«ما الشركات في السعودية التي تقدم خدمات GEO وAI Search Optimization؟»
ثم:
“Which GCC agencies specialize in AI Visibility?”
ثم سؤال مختلف تماماً:
«لماذا يظهر منافسي في ChatGPT عندما يسأل العملاء عن مجالنا بينما لا تظهر شركتي؟»
بعدها نقيس النتائج.
هل ظهرت العلامة التجارية؟
كم مرة؟
في أي نموذج؟
في أي نوع من الأسئلة؟
هل تم ذكرها فقط أم تم ترشيحها؟
هل ظهر موقعها كمصدر؟
كيف وصفها النموذج؟
هل ظهرت في العربية والإنجليزية؟
هل تختلف النتائج بين الإمارات والسعودية وبقية أسواق الخليج؟
هذا ما أسميه:
Observed AI Visibility
| البعد | GEO | AI Visibility |
|---|---|---|
| السؤال الأساسي | ماذا نفعل لكي نظهر؟ | إلى أي مدى نظهر فعلياً؟ |
| الطبيعة | Optimization | Measurement / Outcome |
| التركيز | المحتوى، Entity، Retrieval، Technical Readiness | Mention، Citation، Recommendation، Share of Model |
| مثال | تحسين JSON-LD | قياس عدد مرات ظهور العلامة |
| مثال | تحسين بنية المحتوى للاسترجاع | معرفة النماذج التي تتعرف على العلامة |
| مثال | Digital PR | قياس أثر المصادر الخارجية |
| مثال | Entity Disambiguation | التأكد من أن النموذج تعرف على الـEntity الصحيح |
| النتيجة | رفع مستوى الجاهزية | دليل على الظهور الحقيقي |
| هل يضمن الظهور؟ | لا | يقيس الظهور نفسه |
| الأدوات | Audit & Diagnostics | Benchmark & Monitoring |
بالتالي:
GEO ≠ AI Visibility
لكن:
GEO يمكن أن يؤثر في AI Visibility.
هذه من أكثر النقاط التي أرى أنها تحتاج إلى توضيح.
لنفترض أن ChatGPT استخدم مقالاً من موقعك للإجابة عن سؤال، ووضع الصفحة كمصدر.
لكن اسم علامتك التجارية لم يظهر في نص الإجابة.
لديك:
Citation
لكن هل حصلت العلامة التجارية نفسها على Visibility حقيقية أمام المستخدم؟
ليس بالضرورة.
والعكس ممكن.
قد يقول النموذج:
«يمكن أيضاً النظر في شركة X ضمن الخيارات المتاحة.»
لكنه لا يضع رابطاً إلى موقعها.
لدينا هنا:
Mention بدون Citation.
في دراسة لـSemrush شملت 3,981 حالة ظهور لنطاقات، أفادت النتائج بأن 62% من الـcitations لم تؤدِ إلى ذكر العلامة التجارية نفسها.
المصدر: Semrush — The Ghost Citations Study
لهذا السبب لا يمكن قياس AI Visibility بمجرد عدّ الروابط.
علينا على الأقل الفصل بين:
Mention ≠ Citation ≠ Recommendation ≠ Position ≠ Share of Model
في Molavi GEO Pyramid حاولت تمثيل الرحلة التي يمر بها الـEntity من مجرد وجوده على الإنترنت إلى أن يصبح شيئاً تستطيع الأنظمة الذكية اكتشافه وفهمه واسترجاعه والثقة به وربما اختياره.
التفاصيل: Molavi GEO Pyramid
قسمت هذه الرحلة إلى خمس طبقات.
L1 — Grounded Data & Machine Infrastructure
في البداية يجب أن تستطيع الآلة الوصول إلى المعلومات.
ندخل هنا في أمور مثل:
Semantic HTML، بنية DOM، Crawlability، Structured Data، Canonical، Rendering والبنية التقنية للموقع.
L2 — Entity Authority & Knowledge Graph
بعد ذلك يجب أن يفهم النظام:
من أنت؟
الشركة، المؤسس، الأشخاص، المنتجات، الخدمات، التخصصات والعلاقات بينها وبين المصادر الخارجية يجب أن تكون واضحة بما يكفي.
L3 — RAG Retrieval & Contextual Alignment
قابلية القراءة وحدها ليست كافية.
عندما يأتي السؤال المناسب، يجب أن تكون المعلومة الصحيحة:
قابلة للاسترجاع — Retrievable.
L4 — Multi-LLM Citation & Source Trust
هنا تظهر أهمية الثقة.
هل هناك مصادر أخرى تؤكد ادعاءاتك؟
هل لديك First-party Data؟
هل هناك أبحاث أو تقارير أو تغطية إعلامية أو Repositories أو Datasets أو مصادر مستقلة مرتبطة بالـEntity؟
L5 — Zero-Prompt Agentic Mindshare
وهذه بالنسبة لي أصعب طبقة.
المستخدم لم يعد يذكر اسمك.
لا يسأل مثلاً:
«ما أداة GEO التي طورها Taqi Molavi؟»
بل يسأل:
«اقترح أداة Open Source لقياس AI Visibility.»
إذا استطاع النظام الوصول إلى GEO-Scope كخيار مناسب من دون أن يظهر اسمي في الـPrompt أصلاً، فنحن نتحدث عن مستوى مختلف.
أسميه:
Zero-Prompt Agentic Mindshare
MAVI اختصار لـ:
Molavi AI Visibility Index
لكن الهدف من MAVI ليس إعطاء الشركة رقماً تسويقياً مثل:
«درجة GEO لموقعك 82 من 100!»
الهدف هو الربط بين عالمين مختلفين:
Readiness
و:
Observed Visibility
يمكننا قياس كثير من إشارات الجاهزية التقنية والدلالية.
لكن إذا لم نقم بقياس الظهور الحقيقي، فلا ينبغي اختراع رقم له.
يجب أن تكون النتيجة ببساطة:
not_measured
أو:
insufficient_data
ربما هذا أقل إثارة من الناحية التسويقية.
لكنه أكثر نزاهة من الناحية البحثية.
لنفترض أن موقع شركة في الرياض لديه:
Structured Data ممتازة،
Entity واضحة،
صفحات قابلة للوصول،
محتوى منظم،
إجابات مباشرة قابلة للاستخراج،
وCitation Readiness جيدة.
يمكننا القول إن الموقع يمتلك:
Strong Readiness Signals
لكن لا يمكننا القفز من ذلك إلى:
«ChatGPT سيقترح هذه الشركة.»
هذه نتيجة مختلفة.
ولإثباتها نحتاج إلى Measurement حقيقي.
بدلاً من إبقاء هذه الأفكار في مستوى المقالات فقط، بدأت بتحويل أجزاء من المنهجية إلى أدوات Open Source.
يمكن تبسيط المعمارية هكذا:
Discovery → Measurement → Diagnostics → Action → Agent Integration
GEO-Scope مصمم لمراقبة إجابات أنظمة AI بشكل تجريبي.
يمكننا من خلاله تسجيل:
أي Entity ظهر؟
أي علامة تم ترشيحها؟
ما الـCitation الذي ظهر؟
ما موقع الـEntity في الإجابة؟
أي Provider أنتجها؟
ما الـPrompt؟
ما اللغة؟
ما السوق؟
والأهم:
ما هي Raw Response الأصلية؟
بدلاً من الاحتفاظ بـScore فقط، يمكن الحفاظ على سلسلة أدلة مثل:
Prompt → Raw Response → Observation → Citation → Error → Checksum
المشروع مفتوح المصدر: GEO-Scope on GitHub
إذا قلت لك:
«AI Visibility لعلامتك في Gemini هي 27%.»
يجب أن يكون من حقك أن تسأل:
بناءً على أي Prompts؟
متى أجري القياس؟
أي Model؟
أي لغة؟
كيف تم احتساب Mention؟
ما الـAliases المستخدمة؟
كيف تم التعامل مع تشابه أسماء الشركات؟
هل استبعدنا أخطاء API؟
هل كانت النتائج Live؟
وهل يمكنني رؤية الإجابات الأصلية؟
إذا لم نستطع الإجابة عن هذه الأسئلة، فقد يتحول AI Visibility Score من Benchmark إلى رقم تسويقي.
في Global AI Answers Benchmark 2026.2 تم استخدام:
500 Prompt محلي
عبر:
50 دولة
وبأكثر من:
22 لغة
وشملت البيانات:
73 Entity
و:
626 Raw Completion
و:
45,698 Parsed Observation
عبر أربعة Model Adapters.
أما النسخة التجريبية السابقة فتضمنت:
100 Prompt
عبر:
10 دول
و:
8 لغات
مع:
298 Raw Completion
و:
8,940 Entity Observation
البيانات والمنهجية: GEO-Scope
المغزى ليس استعراض حجم الأرقام.
المغزى هو:
AI Visibility يحتاج إلى Sampling وBenchmarking.
سؤال واحد لـChatGPT ليس Benchmark.
نشرت أيضاً داخل GEO-Scope Benchmark مخصصاً لوكالات التسويق الرقمي في إيران.
يشمل:
30 Prompt
ضمن:
5 Intent Strata
لـ:
8 وكالات
وبإجمالي:
120 Model Completion
لماذا أذكر تجربة إيرانية في مقال موجه إلى الخليج؟
لأن أحد الأخطاء التي أراها في GEO هو افتراض أن كل شيء يجب أن يُبنى انطلاقاً من السوق الأمريكي واللغة الإنجليزية.
منطقة الخليج والشرق الأوسط بيئة متعددة اللغات والأسواق.
العربية والإنجليزية والفارسية والتركية وغيرها تتقاطع داخل المنطقة.
وسلوك المصادر المحلية لا يتطابق بالضرورة مع الولايات المتحدة.
لهذا السبب أرى أن Multilingual & Multi-market Benchmarking جزء أساسي من مستقبل AI Visibility في منطقتنا.
في SEO اعتدنا على نموذج واضح:
Keyword X → Position 3
لكن أنظمة LLM أكثر تعقيداً.
الإجابة قد تكون Probabilistic.
الـModel يتغير.
Retrieval يتغير.
Context يتغير.
اللغة قد تغير النتيجة.
السوق والموقع الجغرافي قد يؤثران.
وحتى صياغة السؤال قد تغير الـEntities التي تظهر.
لذلك بدلاً من القول:
«نحن رقم 2 في ChatGPT في السعودية.»
الأدق أن نقول:
ضمن Dataset محدد، وفترة قياس محددة، ومجموعة Prompts محددة، ولدى Providers محددين، ظهر هذا الـEntity بهذه النسبة.
قد تكون الجملة أقل جاذبية.
لكنها أكثر علمية.
لنفترض أن شركة SEO تقول:
قمنا بتحسين Titles.
رفعنا سرعة الموقع.
بنينا Backlinks.
ونشرنا Content.
ثم تسأل:
«وماذا حدث؟»
فيقولون:
«لا نعرف. لم نراجع Search Console ولم نقس Rankings.»
هل سيكون ذلك مقبولاً؟
GEO يجب ألا يكون مختلفاً.
إذا طبقنا Schema،
وبنينا Entity Graph،
ونفذنا Digital PR،
ونشرنا Content،
وحسنّا Retrieval،
وبنينا Citation-worthy Assets،
لكن لم نحدد Baseline ولم نعد القياس:
كيف نعرف أن العمل نجح؟
لذلك أفضّل دورة:
Measure → Diagnose → Fix → Re-measure
وليس:
Audit → Score → PDF → انتهى المشروع.
إذا كان GEO-Scope يحاول الإجابة عن:
«ماذا حدث فعلياً؟»
فإن SAGE أقرب إلى:
«ما المشكلات القابلة للملاحظة التي قد تحد من جاهزيتنا؟»
SAGE هو Open-source Audit Engine لـTechnical SEO وAEO وGEO Readiness.
ويعمل على إنتاج:
Finding + Evidence + Recommendation
بشكل منظم.
التفاصيل: SAGE Audit Open Source Engine
إذا اكتشفنا المشكلة، لماذا يجب أن ينتهي كل شيء بتقرير PDF طويل؟
SiteProbe مبني حول Workflow أقرب إلى:
Audit → Findings → Remediation Plan → Safe Fix → Verify → Re-measure
ويمكن استخدامه لاكتشاف مشكلات في:
Technical SEO،
On-page،
Schema،
GEO/AEO Readiness،
Rendering،
وجودة الموقع التقنية.
المشروع: SiteProbe on GitHub
ومرة أخرى:
GEO Score هنا يمثل:
Technical Readiness
وليس ضماناً بأن ChatGPT سيقوم بعمل Citation.
مشروع آخر ضمن هذه المنظومة هو:
MCP GEO Server
والفكرة هي إتاحة بعض قدرات GEO Audit لأنظمة AI والـAgents من خلال Model Context Protocol.
يمكن للـAgent مثلاً أن يطلب:
Audit this URL.
Check this Entity.
Analyze Citation Readiness.
Evaluate GEO Readiness.
Run a Measurement.
المشروع: MCP GEO Server on GitHub
وهذا مهم لأن المستقبل لا يتعلق فقط بـ:
Search
بل أيضاً بـ:
Agentic Discovery
إذا كانت استراتيجية AI Visibility لديك بالكامل هي:
«سأقوم بعمل GEO لموقعي.»
فأنت على الأرجح ترى نصف الصورة فقط.
قد تتعرف أنظمة AI على علامتك من:
وسائل الإعلام،
الأدلة المحلية،
GitHub،
الأبحاث الأكاديمية،
منصات التواصل،
Reviews،
المواقع المتخصصة،
ملفات الخبراء والمديرين،
Knowledge Bases،
المنتديات،
المقابلات،
Datasets،
والمصادر المستقلة.
لذلك:
Website Visibility ≠ Brand Visibility
الموقع أصل رقمي أساسي.
لكنه ليس العلامة التجارية كلها.
ناقشت هذا التحول أيضاً في:
From the First Websites to AI Visibility
الإنترنت يتحول تدريجياً إلى شيء يشبه:
الذاكرة القابلة للقراءة آلياً للسوق.
إذا لم تكن هناك معلومات موثوقة كافية عن شركتك داخل هذه الذاكرة، فإن كونك شركة ممتازة في العالم الحقيقي لا يضمن أن أنظمة AI ستفهم ذلك.
إذا كتبت في موقعك:
«نحن أفضل شركة في الخليج في مجال X.»
فهذا:
Self-Claim
أما إذا تحدثت مصادر مستقلة وموثوقة عن أبحاثك، ومشاريعك، وبياناتك، ومنتجاتك وخبراتك، فيبدأ شيء آخر بالتشكل:
Evidence Graph
لهذا لا أرى Digital PR منفصلاً تماماً عن GEO.
القيمة ليست دائماً في Backlink فقط.
أحياناً القيمة الأكبر للـMention الخارجي هي أنه يربط:
Entity + Topic + Evidence
داخل Corpus مستقل.
Local GEO مهم جداً في أسواق مثل الإمارات والسعودية وقطر والكويت والبحرين وعُمان، لأن كثيراً من نوايا البحث التجارية مرتبطة بالموقع.
تخيل مطعماً في الرياض.
GEO قد يتطلب:
اتساق اسم النشاط التجاري،
العنوان،
ساعات العمل،
Location Entity واضحة،
صفحات محلية قوية،
Reviews،
Structured Data،
مصادر محلية،
وإشارات تؤكد نوع النشاط وموقعه وخدماته.
لكن AI Visibility يسأل:
عندما يقول المستخدم:
«اقترح مطعماً مناسباً لاجتماع عمل في منطقة الملك عبدالله المالية بالرياض.»
هل يظهر المطعم؟
ماذا عن ChatGPT؟
Gemini؟
Perplexity؟
إذا كان السؤال بالعربية؟
إذا كان بالإنجليزية؟
إذا كان المستخدم سائحاً بدلاً من مقيم؟
هذا هو الفرق بين:
Local GEO
و:
Local AI Visibility Measurement
للاطلاع على منهجي السابق في هذا الموضوع: Local GEO Guide
هذه نقطة مهمة جداً في منطقتنا.
الأنظمة المحلية ليست متطابقة.
منصات التقييم تختلف.
استخدام الخرائط يختلف.
المصادر الإعلامية تختلف.
اللغات تختلف.
سلوك المستهلك يختلف.
والعلاقة بين العربية والإنجليزية داخل السوق الخليجي نفسها تخلق طبقة إضافية من التعقيد.
شركة في دبي مثلاً قد يكون لديها:
اسم عربي،
اسم إنجليزي،
اختصار تجاري،
اسم قانوني،
وطرق مختلفة لكتابة الاسم في المصادر.
إذا لم نستطع Resolve هذه الـEntities بشكل صحيح، فقد يكون القياس نفسه خاطئاً.
لنفترض أن شركة معروفة جداً بالإنجليزية.
هل هذا يعني أنها تمتلك AI Visibility قوية بالعربية؟
ليس بالضرورة.
بل قد يكون الشخص نفسه مكتوباً بعدة أشكال.
مثلاً:
Taqi Molavi
Taghi Molavi
تقي مولوي
Molavi
إذا اعتبر النظام هذه الأسماء Entities مختلفة، فقد تتشوه نتائج القياس.
لهذا السبب يدعم تصميم GEO-Scope مفاهيم مثل:
Multilingual Aliases
و:
do_not_confuse
للمساعدة في Entity Resolution.
لأن:
إذا كان Entity Resolution خاطئاً، فالـMetric نفسها قد تكون خاطئة.
| Metric | ماذا يخبرنا؟ |
|---|---|
| Mention Rate | في كم نسبة من الإجابات يظهر اسم العلامة؟ |
| Citation Rate | كم مرة يظهر الموقع أو المصدر كـCitation؟ |
| Recommendation Rate | كم مرة يتم ترشيح العلامة فعلياً؟ |
| First Mention / Top Position | كم مرة تظهر ضمن الخيارات الأولى؟ |
| Share of Model | ما حصتنا من الظهور مقارنة بالمنافسين؟ |
| Prompt Coverage | في كم نوع من Intent نظهر؟ |
| Provider Coverage | في كم نظام AI نظهر؟ |
| Language Coverage | في أي لغات نتواجد؟ |
| Geographic Coverage | في أي أسواق يظهر الـEntity؟ |
| Entity Accuracy | هل تعرف النظام على الـEntity الصحيح؟ |
| Attribution | هل نُسبت المعلومات إلى الجهة الصحيحة؟ |
| Citation Sources | ما المصادر التي يعتمد عليها AI لفهم العلامة؟ |
| Temporal Stability | هل الظهور مستقر عبر الزمن؟ |
مهم، ولكن يجب التعامل معه بحذر.
مجرد ظهور العلامة لا يعني أن الظهور إيجابي.
قد تظهر الشركة في 70% من الإجابات، لكن النموذج يقول:
«الشركة معروفة في السوق، إلا أن المعلومات المستقلة التي تثبت خبرتها في X محدودة.»
وهذا مختلف تماماً عن:
«الشركة متخصصة في X، وهناك عدة مصادر مستقلة توثق أعمالها في هذا المجال.»
لذلك السؤال ليس فقط:
هل أظهر؟
بل أيضاً:
كيف يتم تمثيلي؟
لا.
وأعتقد أن السؤال نفسه غير دقيق.
SEO ما زال جزءاً أساسياً من البنية التحتية لهذا العالم.
إذا كانت الصفحة غير قابلة للـCrawl،
أو Canonical خاطئة،
أو Rendering معطلاً،
أو المحتوى غير قابل للاستخراج،
أو بنية الموقع فوضوية،
أو الـEntities غامضة،
فلماذا نتوقع أن تعمل أنظمة Retrieval الأكثر تعقيداً بشكل مثالي؟
أنا أرى التطور أقرب إلى:
SEO → AEO → GEO → AI Visibility → Agentic Visibility
ليست بالضرورة بدائل تلغي بعضها.
بل طبقات تُبنى فوق بعضها.
بمفرده؟
لا.
قد يكون llms.txt جزءاً من Machine-facing Infrastructure.
لكن وجوده لا يثبت أن:
النموذج يعرف علامتك،
أو Retriever سيختار محتواك،
أو ستحصل على Citation،
أو سيتم ترشيح شركتك.
لذلك أتعامل معه في أدواتي كـ:
Technical Signal
وليس:
Proof of AI Visibility
Schema تساعد الأنظمة على فهم الـEntities والعلاقات بينها.
لكن:
Schema ≠ Authority
و:
Schema ≠ Recommendation
Structured Data يجب أن تمثل الواقع.
لا أن تخترع السلطة الرقمية.
لا أعتقد ذلك.
إنتاج النص أصبح Commodity.
عندما يستطيع الجميع إنتاج مئات المقالات العامة بسرعة، فإن حجم المحتوى وحده يفقد جزءاً من قيمته التنافسية.
ما أصبح أكثر ندرة؟
First-party Data.
التجارب الحقيقية.
Experiments.
Benchmarks.
وجهة النظر الأصلية.
Tools.
Datasets.
Independent Sources.
والأهم:
Evidence
لهذا أستثمر في بناء Benchmarks وأدوات Open Source بدلاً من الاكتفاء بكتابة المزيد من المقالات عن GEO.
إذا قدمت Framework جديداً لـAI Visibility وكنت أنا الوحيد الذي يكتب عنه، فلدي:
Claim
لكن إذا أصبحت:
المنهجية منشورة،
والكود مفتوحاً،
والـDataset متاحاً،
والـBenchmark قابلاً للتكرار،
والـRaw Evidence محفوظة،
ويستطيع باحث آخر فحص النتائج،
فإن الـClaim يبدأ بالتحول إلى:
Verifiable Asset
ولهذا لا أنظر إلى GEO-Scope وSAGE وSiteProbe وMCP GEO Server باعتبارها Software Projects فقط.
بل أيضاً كجزء من:
Entity & Evidence Architecture
أنظر اليوم إلى GEO من خلال خمسة محاور:
Technical
هل تستطيع الآلة الوصول إلى المعلومات؟
Semantic
هل تفهم عن أي Entity وموضوع نتحدث؟
Retrieval
هل يمكن استرجاع الـPassage الصحيح عند طرح السؤال المناسب؟
Authority
هل توجد Evidence كافية لبناء الثقة؟
Measurement
هل يظهر الـEntity فعلياً في الإجابات؟
المحاور الأربعة الأولى بدون الخامس تتركنا أمام نظام غير مكتمل.
تخيل شركة صناعية عمرها 30 عاماً في السعودية.
منتجاتها ممتازة.
لديها عملاء كبار.
معروفة داخل القطاع.
لكن موقعها يتكون من خمس صفحات قديمة.
مديروها ليس لديهم حضور رقمي واضح.
التغطية المستقلة محدودة.
لا توجد Case Studies قوية.
لا توجد بيانات منظمة جيدة للمنتجات.
ولا يوجد محتوى تقني يشرح خبرتها الحقيقية.
ثم يسأل مدير مشتريات AI:
«قارن بين ثلاث شركات موثوقة لتوريد المنتج X في السعودية واشرح نقاط قوة كل شركة.»
إذا لم تظهر الشركة في الإجابة، هل يعني ذلك أنها سيئة؟
لا.
قد يعني شيئاً مختلفاً تماماً:
الجودة الموجودة في العالم الحقيقي لم تتحول بعد إلى أدلة رقمية يمكن للآلة اكتشافها وفهمها واسترجاعها والتحقق منها.
AI Visibility يجعل هذه الفجوة مرئية.
لسنوات كان هدف SEO الأساسي:
اظهر.
ثم أدركنا أن الظهور بدون Conversion غير كافٍ:
اظهر → بِع.
الآن، مع دخول الأنظمة الذكية بين العميل والسوق، تظهر طبقة أخرى:
اظهر → ابنِ الثقة → يتم اختيارك → كن العلامة.
هنا تلتقي:
SEO،
GEO،
Digital PR،
Entity Building،
Content،
وAI Visibility.
أعتقد أن المرحلة التالية قد تكون أهم من AI Search نفسه.
اليوم:
الإنسان يسأل.
والذكاء الاصطناعي يجيب.
غداً قد يقوم Agent بنفسه بـ:
البحث،
مقارنة الخيارات،
اختيار الأدوات،
استدعاء APIs،
تحليل البيانات،
إعداد تقرير،
وتجهيز جزء من القرار قبل أن يراجعه الإنسان.
في ذلك العالم لن يكون السؤال فقط:
«هل ذكر ChatGPT اسمي؟»
بل:
«هل أدخل الـAgent شركتي أو منتجي أو بحثي أو بياناتي أو أداتي ضمن عملية اتخاذ القرار؟»
وهنا تظهر أهمية الطبقة الخامسة من Molavi GEO Pyramid:
Zero-Prompt Agentic Mindshare
لا يحتاج المستخدم إلى معرفة اسمك مسبقاً.
النظام يكتشفك لأنك:
Relevant،
Retrievable،
ومدعوم بما يكفي من Trust وEvidence.
إذا أردت الاحتفاظ بجملة واحدة من هذا المقال، فلتكن:
GEO هو مجموعة الممارسات التي تهدف إلى زيادة احتمالية فهم الـEntity واسترجاعه والثقة به واختياره من قبل الأنظمة التوليدية؛ أما AI Visibility فهو القياس التجريبي لمدى ظهور هذا الـEntity فعلياً في إجابات الذكاء الاصطناعي، وأين يظهر، وكم مرة، وفي أي سياق.
أستخدم هذا النموذج للتفكير في AI Visibility:
AI Visibility = Discoverability × Understandability × Retrievability × Trust × Observed Presence
هذه ليست معادلة إحصائية رسمية.
إنها نموذج ذهني.
قد تكون شركتك موثوقة جداً لكن الآلة لا تستطيع اكتشافها.
قد تكتشفها لكنها لا تفهم الـEntity بشكل صحيح.
قد تفهمها لكنها لا تسترجع المحتوى المناسب عند السؤال.
قد تسترجع المحتوى لكن لا تجد Evidence كافية للترشيح.
وقد يبدو كل شيء ممتازاً تقنياً، ثم نجري Benchmark حقيقياً فلا تظهر العلامة.
هذه الخطوة الأخيرة لا يمكن تخمينها.
يجب قياسها.
هل GEO وAI Visibility الشيء نفسه؟
لا.
GEO يتعلق أساساً بالـOptimization.
AI Visibility يتعلق بالظهور الحقيقي والـMeasurement.
هل GEO سيستبدل SEO؟
لا.
SEO ما زال طبقة مهمة من Discovery وRetrieval Infrastructure.
GEO يوسع المشكلة من Ranking الصفحات إلى Entity وRetrieval وCitation وGenerative Answers.
هل تصدّر Google يعني AI Visibility قوية؟
ليس بالضرورة.
قد تساعد Search Visibility القوية، لكن أنظمة AI تستطيع الاعتماد على مصادر مختلفة واختيار Entities مختلفة.
هل Citation تعني AI Visibility؟
Citation جزء من AI Visibility وليست كلها.
هناك أيضاً Mention وRecommendation وPosition وShare of Model وPrompt Coverage وProvider Coverage وغيرها.
هل سؤال ChatGPT مرة واحدة يكفي؟
لا.
Generative Models احتمالية، ويمكن أن تتغير النتائج باختلاف Prompt والنموذج واللغة وRetrieval وContext والموقع والزمن.
هل يمكن ضمان AI Visibility بنسبة 100%؟
لا.
لا يملك أي مستشار خارجي تحكماً كاملاً في Retrieval أو Training Data أو Model Behavior أو خوارزميات مزود آخر.
يمكن تحسين Readiness.
ويمكن قياس Visibility.
أما ضمان مخرجات نموذج خارجي فهو ادعاء مختلف.
ما هو Local GEO؟
هو بناء هوية محلية ونظام أدلة تستطيع محركات البحث وأنظمة الإجابة اكتشافه وفهمه والتحقق منه.
ما هو MAVI؟
MAVI أو Molavi AI Visibility Index هو Framework لتقييم طبقات AI Readiness وObserved Visibility بصورة أكثر اعتماداً على الأدلة.
ما هو GEO-Scope؟
Framework مفتوح المصدر لقياس كيفية Mention وRecommendation وCitation وAttribution للـEntities في إجابات AI.
ما هو SAGE؟
Open-source Audit Engine لـTechnical SEO وAEO وGEO Readiness.
ما هو SiteProbe؟
أداة مفتوحة المصدر لدعم Audit وRemediation Planning وSafe Fix وVerification وRe-measurement.
لسنوات كان السؤال الرئيسي للشركات:
«كيف نتصدر Google؟»
اليوم يظهر سؤال أكبر:
«عندما يسأل إنسان أو AI Agent عن مجالنا، هل نحن جزء من الإجابة؟»
GEO جزء من الطريق إلى هذه النتيجة.
لكنه ليس النتيجة نفسها.
يمكن أن تنفذ كل GEO Checklist ولا تظهر.
يمكن أن تظهر لكن يتم فهمك بشكل خاطئ.
يمكن أن تحصل على Citation بدون Mention.
يمكن أن تحصل على Mention بدون Recommendation.
يمكن أن تكون قوياً في ChatGPT وضعيفاً في Gemini.
يمكن أن تكون معروفاً بالإنجليزية وغير مرئي تقريباً بالعربية.
بل يمكن أن تختلف Visibility بين الإمارات والسعودية وبقية الأسواق رغم أن اللغة الأساسية واحدة.
لذلك لا أعتقد أن المرحلة التالية من الصناعة هي فقط:
Generative Engine Optimization
بل:
قياس AI Visibility وتفسيرها وهندستها.
في الويب القديم كنا نحاول أن نجعل:
الصفحة تحصل على Ranking.
في عالم AI نحاول أن نجعل:
الـEntity مفهوماً.
وفي المرحلة التالية يجب أن يصبح هذا الـEntity موثوقاً وقابلاً للاسترجاع ومفيداً بما يكفي لكي يضعه إنسان أو Agent ضمن الإجابة أو عملية اتخاذ القرار:
حتى لو لم يكن يعرف اسمه مسبقاً.
وهذا هو المسار الذي أعمل عليه من خلال:
Molavi GEO Pyramid
و:
MAVI
و:
Molavi AI Visibility Stack
من:
Machine Readability
إلى:
Entity Authority
ثم:
Retrieval
ثم:
Citation & Trust
وصولاً إلى:
Zero-Prompt Agentic Mindshare
ليس الهدف أن نتحدث فقط عن GEO.
بل أن نستطيع:
قياسه، اختباره، تحسينه، ثم قياسه من جديد.
Taqi Molavi | تقي مولوي AI Systems Architect | SEO, GEO & AI Visibility Strategist Molavi R&D Think Tank