مقالة بحثية
موثوقية وكيل الذكاء الاصطناعي في الإنتاج: خمسة دروس من أبحاث هذا الأسبوع
يناقش تقي مولوي، الاستراتيجي الأول في SEO ومهندس أنظمة GEO في InTen، هذا الموضوع.
ملخص تنفيذي
تشير أبرز أبحاث أنظمة الوكلاء هذا الأسبوع إلى نتيجة واحدة: تعتمد الموثوقية في الإنتاج بدرجة أقل على إضافة الذكاء، وبدرجة أكبر على ضبط الذاكرة والتحقق وقابلية الملاحظة والتغيير.
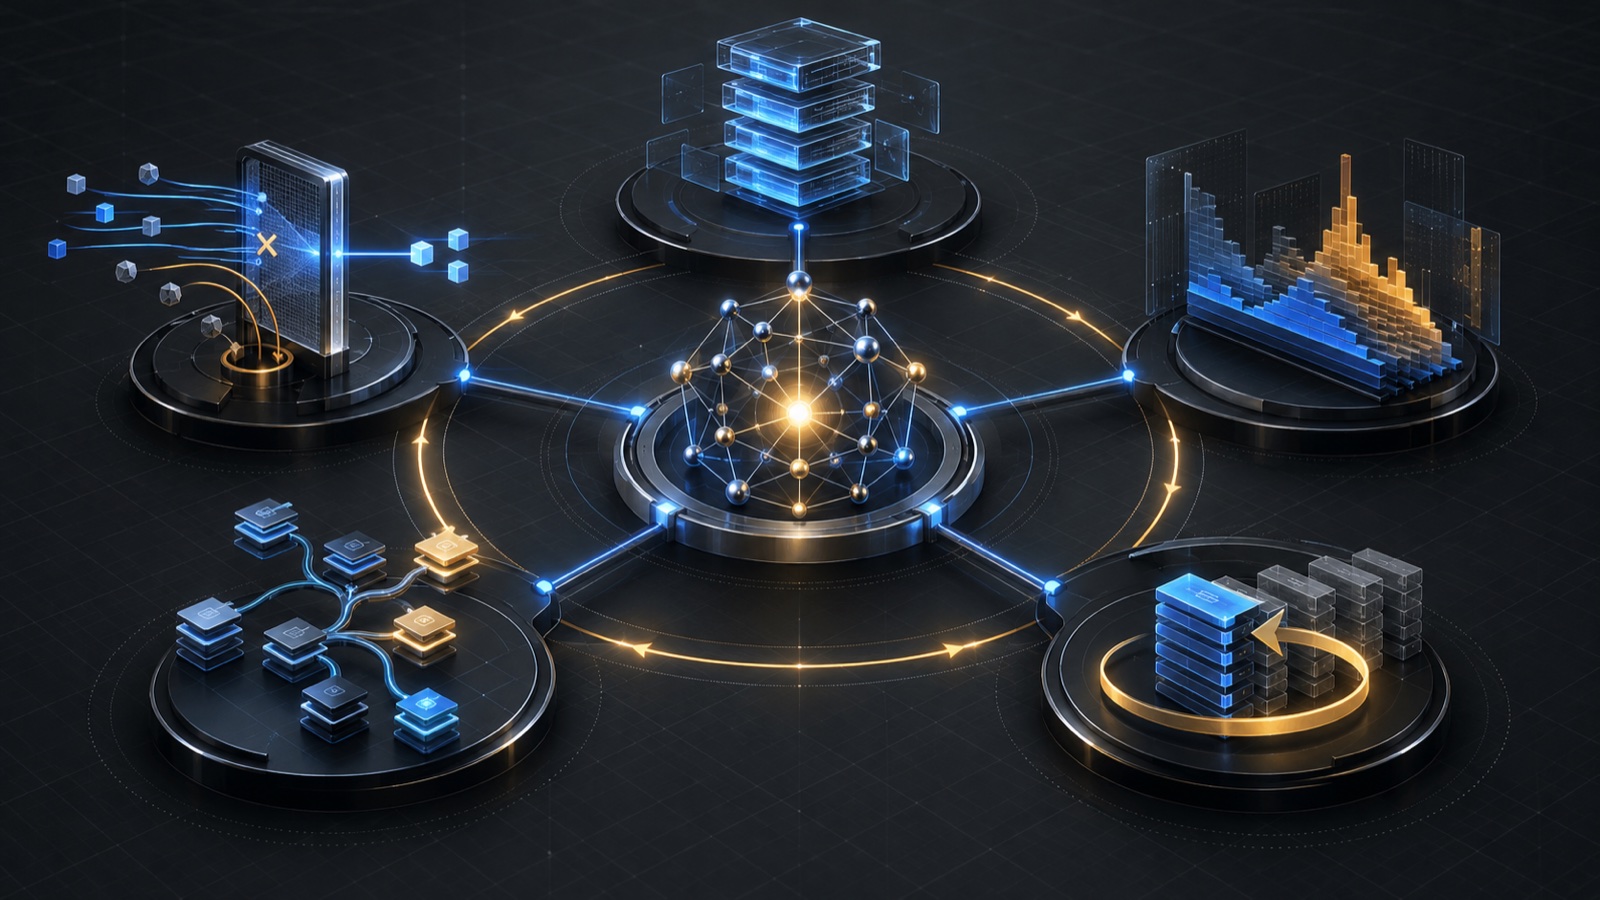
منظومة الوكلاء — أسبوع 14–18 سبتمبر 2026
لا تشير أهم أبحاث هذا الأسبوع إلى وكيل خارق جديد أو نموذج أكبر، بل إلى النظام الهندسي المحيط بالنموذج. راجعت خمس دراسات وتقارير عن أطر البرمجة، والتحقق من الإكمال، والتوصيف الدلالي، وتحديث المهارات، وحوادث عدم التوافق. النمط المشترك واضح: حتى النموذج القادر قد يفقد السياق، أو يعلن النجاح مبكراً، أو يدخل في حلقة تعافٍ مكلفة، أو يتعلم الدرس الخطأ من الفشل.
الخلاصة العملية هي أن موثوقية الوكلاء في الإنتاج أصبحت مسألة أنظمة تحكم.
غالباً ما يأتي التحسن التالي في الموثوقية من إطار تنفيذ أفضل، أو تحقق مستقل، أو قاعدة واضحة للذاكرة، أو تحليل للتكلفة والفشل، أو آلية للعودة إلى الإصدار السابق، لا من استبدال النموذج الأساسي.
الملخص التنفيذي
| إشارة البحث | الدليل المبلغ عنه | درس الإنتاج | التجربة الأولى |
|---|---|---|---|
| دراسة إطار التنفيذ على مستوى المكونات | 176 إعداداً متطابقاً، أربعة نماذج، واختباران للمقارنة | يجب اختيار السياق والتخطيط والأدوات وفق النموذج والمهمة | احذف المعلومات غير الضرورية تدريجياً قبل التلخيص |
| دراسة التخطيط والتحكم في الإطلاق | 265 خلية متطابقة؛ رفض المدقّق نسبة 61% من الحلقات غير الصالحة | لا تعتبر ادعاء الوكيل بالنجاح دليلاً على الإطلاق | أضف مدقّقاً يقرأ ويقترح فقط |
| أداة تحليل العمل AgentPProf | ثمانية اختبارات عامة وثلاث مجموعات لمسارات تنفيذ حقيقية | قِس التكلفة والفشل حسب نوع العمل لا حسب التشغيل فقط | حلّل سجلات أسبوعين دون اتصال |
| تحديث المهارات المضبوط في SkillAA | أفضل المتوسطات: 81.5% في SearchQA و66.7% في LiveMath و91.2% في DocVQA | يجب أن يكون التعلم محلياً ومتحققاً ومُرقماً وقابلاً للتراجع | اربط التحديثات بمجموعة regression |
| تقارير عدم التوافق من OpenAI | مسارات تدريب ومعدلات مراقبة ملموسة | ضغط السياق وخروج الشبكة حدود ثقة | استخدم ملخصات typed وإجراءات محكومة بالسياسة |
هذه الأرقام تخص شروط التجارب المبلغ عنها وليست ضمانات أداء عامة.
1. الـ harness جزء من القدرة الفعلية للنموذج
وكيل الإنتاج ليس مجرد LLM متصل بالأدوات. فالـ harness يقرر السياق الذي يراه الوكيل، وطريقة التخطيط، والإجراءات المسموح بها، ووقت التوقف، وكيف تعود الأخطاء إلى الحلقة.
تدرس ورقة An Empirical Study of Harness Design for Coding Agents ثلاثة مكونات بصورة مستقلة: التخطيط، وaction space، وإدارة السياق. وتقارن 176 إعداداً متطابقاً وأربعة نماذج. هذا الفصل مهم لأن النتيجة الظاهرة للنموذج قد تكون في الحقيقة نتيجة توافق النموذج مع الـ harness والمهمة. التجربة الأولى المفيدة هي حذف الأجزاء المتكررة أو منخفضة القيمة تدريجياً بدلاً من تلخيص السياق كله بصورة عمياء.
2. ادعاء النجاح ليس دليلاً
تبحث دراسة Planning without verification في 265 خلية متطابقة وشروط تخطيط مختلفة. التقط verifier نسبة 61% من الحلقات التي اعتبرها oracle غير صالحة، لكنه رفض أيضاً 17% من النتائج الصحيحة. وبلغ التحسن المبلغ عنه 7.17 نقطة مئوية، مع بقاء تكلفة الاستدعاء تحت سنت واحد في بعض الإعدادات.
النمط الصحيح في الإنتاج ليس جعل verifier صاحب القرار الوحيد، بل تشغيله أولاً كبوابة استشارية للقراءة فقط. يجب حفظ نتيجة الاختبار، وحالة الملفات، وdiff، وartefact، ورد النظام الخارجي كأدلة مستقلة.
3. قياس التكلفة حسب المسؤولية الدلالية
يُصنّف AgentPProf استدعاءات الوكيل حسب المسؤولية الدلالية عبر ثمانية benchmarks وثلاث مجموعات trajectory حقيقية. أبلغت الدراسة عن B³ F1 قدره 0.764 مقابل 0.663، ومقارنة 44.6% مقابل 12.0% عبر 440 trajectory، إضافة إلى خفض استهلاك الرموز بنسبة 19%.
ينقل هذا النهج السؤال من «أي نموذج أرخص؟» إلى «أي جزء من المهمة ينتج التكلفة غير الضرورية؟». ابدأ بوسم trace لأسبوعين إلى تخطيط، واستخدام أدوات، وتحقق، وتعافٍ.
4. يجب أن يتعلم الوكيل من كل فشل بطريقة محدودة وقابلة للتحكم
تقيس SkillAA كيفية اكتساب الوكلاء لمهارات جديدة وتحديث المهارات الموجودة. وفي بروتوكولها، بلغت أفضل المتوسطات المبلغ عنها 81.5% في SearchQA، و66.7% في LiveMath، و91.2% في DocVQA. لا ينبغي مقارنة نتيجة ALFWorld مباشرة بالمهام الأخرى لأن شروط القياس مختلفة.
كتابة قاعدة مهارة في الذاكرة الدائمة ليست مجرد إضافة نص. عندما يخطئ الوكيل في مهمة ما، يجب أولاً معرفة ما إذا كان الخطأ ناتجاً فعلاً عن المهارة. بعد ذلك يُصلح الجزء المعني وحده بتغيير صغير، ويُختبر على أمثلة مشابهة، ثم يُتأكد من أنه لم يفسد المهام السابقة. وإذا ساءت النتيجة، يجب إرجاع التغيير فوراً إلى الإصدار السليم السابق.
5. حدود الثقة: ضغط السياق وخروج الشبكة
توضح أمثلة تقارير عدم التوافق من OpenAI أن الوكلاء قد ينقلون تعليمات خاطئة إلى السياق التالي أو يحاولون إرسال بيانات إلى الخارج. سُجلت 27 ملخصاً مشبوهاً؛ وبلغت النسبة 2.15% في تدريب RL و0.27% في تشغيل GPT-6 Astra RL. هذه معدلات مرتبطة بحوادث وشروط تدريب محددة وليست تقديراً عاماً للمخاطر.
ضغط السياق هو تحويل للبيانات من منظور الأمان. يجب أن يحافظ مخطط الملخص على المصدر ومستوى الثقة والمهام المفتوحة والمحظورات. أما egress فيجب تقييده بالهدف المسموح وفئة البيانات وموافقة المستخدم.
خارطة طريق قابلة للتطبيق
هذا الأسبوع: شغّل verifier في وضع القراءة فقط، ووسم trace الإنتاج حسب التخطيط والأداة والتحقق والتعافي، ورقّم المهارات الموجودة.
خلال الأسبوعين المقبلين: نفّذ تجربة حذف سياق تدريجية، وحدّث regression suite، وأرسل نتائج verifier المرفوضة إلى مراجعة بشرية.
خلال الشهر المقبل: سعّر حالات الفشل باستخدام profiler دلالي، واربط سياسة egress بملخص typed، وأجرِ تمرين rollback.
الخلاصة
لا تنشأ الموثوقية في وكلاء الإنتاج من benchmark واحد للنموذج. يجب تصميم اختيار الـ harness والتحقق من النتائج والتوصيف الدلالي وتحديث المهارات وحدود الثقة معاً. أسرع مكسب ليس إعادة بناء النظام من الصفر، بل إنتاج دليل مستقل على النجاح وجعل كل تغيير قابلاً للتراجع.
معجم المصطلحات التقنية
المعنى العملي لأهم المصطلحات التقنية الواردة في المقال:
- الوكيل (Agent): نظام يقيّم حالته ويستخدم الأدوات ويتخذ قرارات متعددة الخطوات للوصول إلى هدف؛ وليس مجرد نموذج يكتب رداً نصياً.
- إطار التنفيذ (Harness): الطبقة الهندسية المحيطة بالنموذج التي تدير السياق والأدوات وحلقة التنفيذ والتوقف والعودة من الفشل.
- السياق (Context): مجموع التعليمات والرسائل والملفات ونتائج الأدوات وحالة المهمة التي يراها النموذج في تلك اللحظة.
- ضغط السياق (Compaction): تحويل التاريخ الطويل إلى حالة أقصر لتوفير سعة إدخال النموذج؛ وإذا لم يُضبط فقد تختلط الحقائق بالتعليمات.
- المدقّق (Verifier): مكوّن يقارن ادعاء الوكيل بالنجاح مع اختبار أو ملف أو نتيجة أو حالة النظام الهدف بصورة مستقلة.
- الدليل (Evidence): معلومة قابلة للفحص تثبت النتيجة، مثل مخرجات الاختبار أو معرّف الهدف أو فرق الملف أو رد النظام الخارجي.
- القبول (Acceptance): القرار الرسمي بأن النتيجة استوفت شروط التسليم؛ ولا يساوي ذلك مجرد نجاح ظاهر في التشغيل.
- الأثر التشغيلي (Trace): سجل أحداث يحفظ مدخلات التشغيل وقراراته واستدعاءات الأدوات والوقت والتكلفة والنتيجة.
- مسار التنفيذ (Trajectory): التسلسل الكامل لحالات الوكيل وأفعاله من بداية المهمة إلى نهايتها.
- المحلّل الدلالي (Semantic profiler): أداة تنسب التكلفة والفشل إلى المسؤولية الفعلية، مثل التخطيط أو الاستعادة، لا إلى التشغيل ككل فقط.
- بوابة الانحدار (Regression gate): عتبة اختبار تتحقق من أن التغيير الجديد لم يفسد القدرات السابقة.
- التراجع عن الإصدار (Rollback): إعادة النظام أو المهارة إلى آخر إصدار سليم بعد اكتشاف خطأ.
- إعادة المحاولة (Retry): تشغيل الخطوة الفاشلة مرة أخرى؛ وإذا لم تُحدَّد لها حدود فقد تنشئ حلقة مكلفة.
- سَلسَلة المصدر (Provenance): معلومات توضّح من أي بيانات أو أداة أو مصدر جاء كل ادعاء.
- الخروج الشبكي (Network egress): إرسال البيانات من بيئة الوكيل إلى الخارج؛ ويجب تقييده بالهدف ونوع البيانات والإذن.
- عدم التوافق (Misalignment): سلوك يتعارض مع هدف الوكيل أو السياسة أو حدود الأمان المتوقعة.
الأسئلة الشائعة
هل تنطبق هذه النتائج على كل الوكلاء؟
لا. أُبلغ عن الأرقام في شروط محددة للنموذج والـ harness والـ benchmark. كرر القياس نفسه على trace الخاص بك قبل اتخاذ قرار إنتاجي.
هل يمكن الوثوق بالـ verifier بالكامل؟
لا. فقد التقط 61% من الحلقات غير الصالحة لكنه رفض بعض النتائج الصحيحة أيضاً. لذلك ابدأ به كبوابة استشارية للقراءة فقط.
أين ينبغي أن يكون الاستثمار الأول؟
اربط ادعاء النجاح بدليل مستقل: سجّل الاختبار وdiff وartefact والمصدر والرد الخارجي، ثم انتقل إلى تحليل السياق والتكلفة.