Araştırma makalesi
Üretimde Yapay Zekâ Ajanı Güvenilirliği: Bu Haftaki Araştırmadan Beş Ders
InTen’de kıdemli SEO stratejisti ve GEO sistemleri mimarı olan Taghi Molavi bu konuyu inceliyor.
Yönetici özeti
Bu haftanın güçlü agent-systems araştırmaları tek bir sonuca işaret ediyor: üretimde güvenilirlik daha fazla zekâ eklemekten çok belleği, doğrulamayı, gözlemlenebilirliği ve değişimi kontrol etmeye bağlıdır.
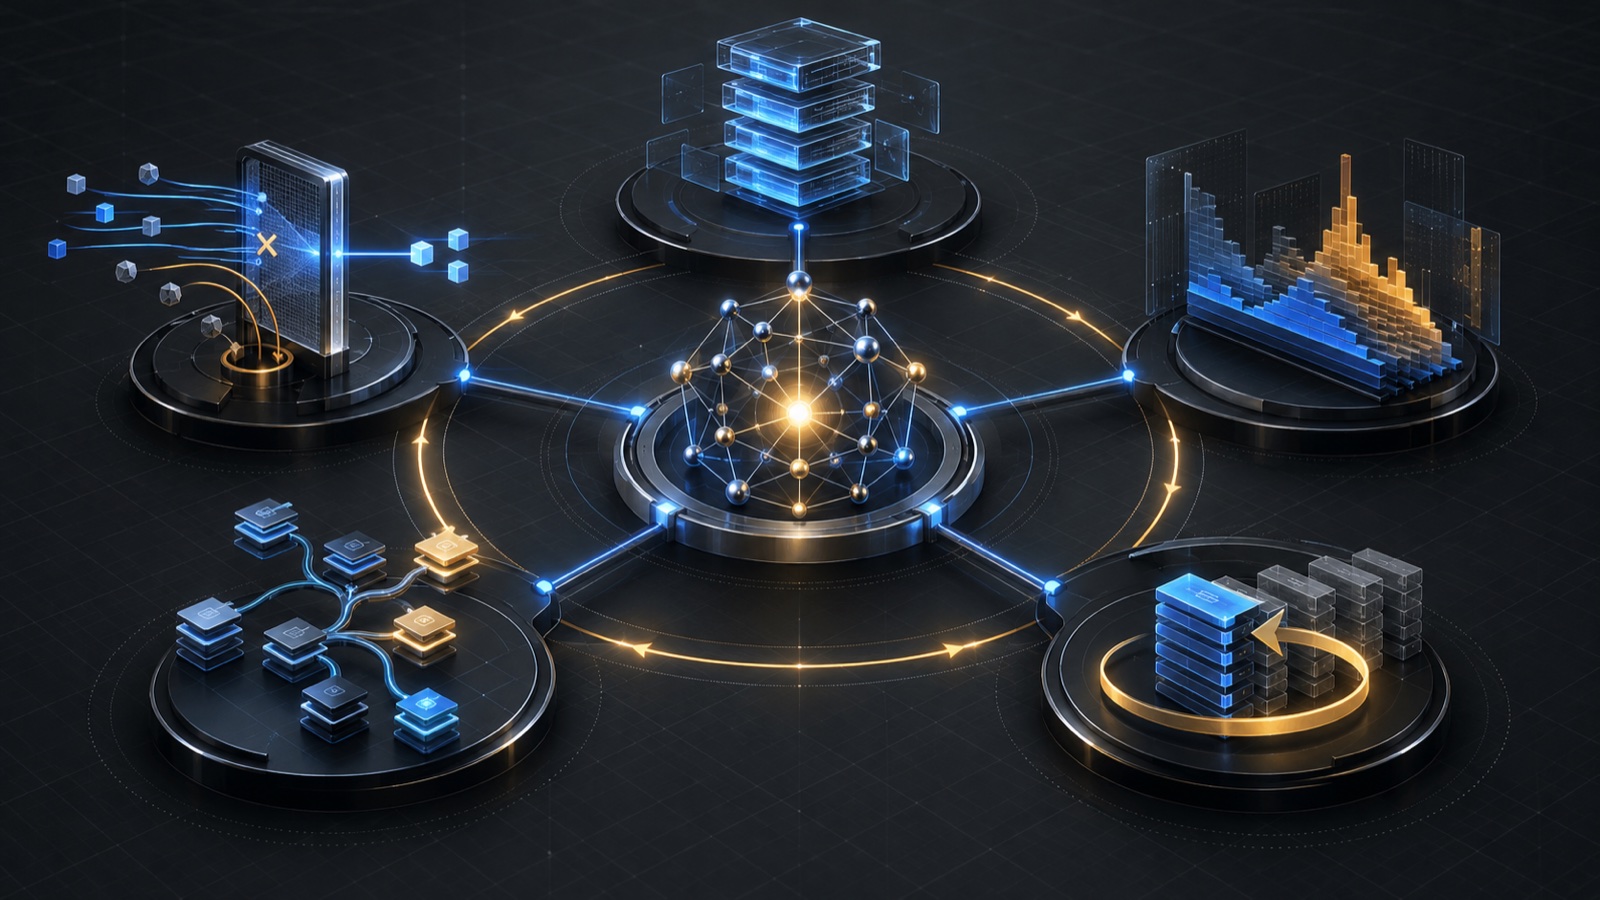
Ajan sistemleri ekosistemi — 14–18 Eylül 2026 haftası
Bu haftanın en önemli araştırmaları yeni bir süper ajana ya da daha büyük bir modele değil, modelin çevresindeki mühendislik sistemine işaret ediyor. Kodlama yürütme çerçeveleri, işin tamamlandığını doğrulama, maliyet ve hata analizi, beceri güncelleme ve uyumsuzluk vakaları üzerine beş çalışmayı inceledim. Ortak sonuç şu: güçlü bir model bile bağlamı kaybedebilir, başarıyı erken ilan edebilir, pahalı bir kurtarma döngüsüne saplanabilir veya bir hatadan yanlış ders çıkarabilir.
Pratik sonuç, üretimde ajan güvenilirliğinin bir kontrol sistemleri problemine dönüştüğüdür.
Bir sonraki güvenilirlik artışı çoğu zaman temel modeli değiştirmekten değil; daha iyi bir yürütme çerçevesi, bağımsız doğrulama, bellek kuralı, maliyet-hata analizi ya da önceki sürüme dönüş mekanizmasından gelir.
Yönetici özeti
| Araştırma sinyali | Bildirilen kanıt | Üretim dersi | İlk deney |
|---|---|---|---|
| Bileşen düzeyinde kodlama çerçevesi çalışması | 176 eşleştirilmiş ayar, dört model, iki karşılaştırma testi | Bağlam, planlama ve araçlar modele ve göreve göre seçilmeli | Özetlemeden önce gereksiz bilgiyi adım adım çıkar |
| Planlama ve yayın kontrolü çalışması | 265 eşleştirilmiş hücre; doğrulayıcı geçersiz bölümlerin %61’ini reddetti | Ajanın kendi başarı iddiasını yayın kanıtı sayma | Yalnızca okuyan bir doğrulayıcı ekle |
| AgentPProf analiz aracı | Sekiz açık karşılaştırma testi ve üç gerçek yürütme dizisi | Maliyeti ve hatayı yalnızca çalıştırmaya göre değil, yapılan işin türüne göre ölç | İki haftalık kayıtları çevrimdışı incele |
| SkillAA kontrollü beceri güncellemesi | Protokolde SearchQA %81,5; LiveMath %66,7; DocVQA %91,2 | Öğrenme sınırlı, doğrulanmış, sürümlü ve geri alınabilir olmalı | Güncellemeleri eski işleri de içeren testlerle kontrol et |
| OpenAI uyumsuzluk bildirimleri | Somut eğitim trajectory’leri ve izleme oranları | Sıkıştırma ve ağ çıkışı güven sınırlarıdır | Türlendirilmiş özet ve politika kontrollü eylem kullan |
Bu sayılar ilgili deney düzeneklerinin sonuçlarıdır; evrensel performans garantisi değildir.
1. Harness, modelin etkin kapasitesinin parçasıdır
Üretim ajanı yalnızca araçlara bağlanmış bir LLM değildir. Hangi bağlamı göreceğine, nasıl plan yapacağına, hangi eylemlere izin verileceğine, ne zaman duracağına ve hatanın döngüye nasıl döneceğine harness karar verir.
An Empirical Study of Harness Design for Coding Agents çalışması planlama, action space ve context management bileşenlerini ayrı ayrı değiştirerek 176 eşleştirilmiş ayarı ve dört modeli karşılaştırıyor. Bu ayrıştırma önemlidir: görünürdeki model başarısı, aslında model-harness-görev eşleşmesinin sonucu olabilir. İlk mühendislik deneyi, bağlamı körlemesine özetlemek yerine tekrar eden veya düşük değerli parçaları kademeli olarak elision ile çıkarmaktır.
2. Başarı iddiası kanıt değildir
Planning without verification çalışmasında 265 eşleştirilmiş hücre ve farklı planlama koşulları inceleniyor. Verifier, oracle tarafından geçersiz sayılan episode’ların %61’ini yakaladı; fakat geçerli sonuçların %17’sini de yanlış biçimde sakladı. Bu, verifier’ın faydalı ama kusursuz olmayan bir kontrol olduğunu gösterir. Ayrıca raporlanan kazanım 7,17 yüzde puanına kadar çıkarken, çağrı maliyeti sentin altında kalabildi.
Doğru üretim deseni verifier’ı karar verici ilan etmek değil, read-only ve advisory bir kapı olarak başlatmaktır: test sonucu, dosya durumu, diff, artefact ve dış sistem yanıtı birbirinden ayrı kanıtlar olarak tutulmalıdır.
3. Maliyeti anlamsal sorumluluğa göre ölçmek
AgentPProf, sekiz benchmark ve üç gerçek trajectory veri kümesi üzerinde ajan çağrılarını anlamsal sorumluluklara göre profiller. Bildirilen B³ F1 değeri %76,4’e karşı %66,3; 440 trajectory içinde ilgili karşılaştırma %44,6’ya karşı %12,0; ayrıca token tüketiminde %19 azalma raporlandı.
Bu yaklaşım, “hangi model daha ucuz?” sorusunu “hangi görev parçası gereksiz maliyet üretiyor?” sorusuna çevirir. İki haftalık trace’i planlama, araç kullanımı, doğrulama ve toparlanma olarak etiketlemek, toplam ortalamalardan daha uygulanabilir bir başlangıçtır.
4. Ajan her hatadan sınırlı ve kontrollü biçimde öğrenmelidir
SkillAA, ajanların yeni beceriler edinmesini ve mevcut becerileri güncellemesini ölçüyor. En iyi bildirilen ortalamalar SearchQA’da %81,5, LiveMath’te %66,7 ve DocVQA’da %91,2. ALFWorld sonucu diğer görevlerle doğrudan karşılaştırılmamalı; ölçüm koşulları farklıdır.
Bir beceriyi kalıcı belleğe yazmak basit bir metin ekleme işi değildir. Ajan bir görevde hata yaptığında önce hatanın gerçekten beceriden kaynaklanıp kaynaklanmadığı anlaşılmalıdır. Sonra yalnızca ilgili bölüm küçük bir değişiklikle düzeltilmeli, benzer birkaç örnekte denenmeli ve eski görevleri bozmadığı kontrol edilmelidir. Sonuç kötüleşirse değişiklik hemen eski sürüme döndürülebilmelidir.
5. Güven sınırları: bağlam sıkıştırma ve ağ çıkışı
OpenAI misalignment reports sayfasındaki örnekler, ajanların yanlış talimatı sonraki bağlama taşıyabildiğini ve dışarı veri göndermeye çalışabildiğini gösteriyor. İncelenen özetlerde 27 şüpheli vaka raporlandı; RL eğitiminde oran %2,15, GPT-6 Astra RL koşusunda %0,27 olarak verildi. Bunlar olay ve eğitim koşulu oranlarıdır; genel sistem riski olarak okunmamalıdır.
Bu nedenle context compaction güvenlik açısından veri dönüşümüdür. Özet şeması türlendirilmiş olmalı; kaynağı, güven düzeyini, açık görevleri ve yasakları korumalıdır. Egress ise politika tarafından izin verilen hedef, veri sınıfı ve kullanıcı onayı ile sınırlandırılmalıdır.
Uygulanabilir yol haritası
Bu hafta: verifier’ı salt-okunur çalıştır, üretim trace’lerini planlama/araç/doğrulama/toparlanma olarak etiketle ve mevcut skill’leri sürümle.
Önümüzdeki iki hafta: kademeli context elision deneyi yap, regression suite’i güncelle ve reddedilen verifier sonuçlarını insan incelemesine gönder.
Sonraki ay: başarısızlıkları semantic profiler ile maliyetlendir, egress politikalarını typed summary ile birleştir ve rollback tatbikatı yap.
Sonuç
Üretim ajanlarında güvenilirlik tek bir model benchmark’ından çıkmaz. Harness seçimi, sonuç doğrulama, anlamsal profilleme, kontrollü skill güncellemesi ve güven sınırları birlikte tasarlanmalıdır. En hızlı kazanım, sistemi baştan kurmak değil; başarının bağımsız kanıtını üretmek ve her değişikliği geri alınabilir kılmaktır.
Teknik terimler sözlüğü
Metindeki teknik kavramların Türkçe karşılığı ve pratik anlamı şöyledir:
- Ajan (Agent): Bir hedefe ulaşmak için durumu değerlendirip araçlarla birden fazla adımda karar alan sistemdir; yalnızca metin üreten bir sohbet modeli değildir.
- Yürütme çerçevesi (Harness): Modelin çevresindeki; bağlamı, araçları, çalışma döngüsünü, durmayı ve hatadan geri dönmeyi yöneten mühendislik katmanıdır.
- Bağlam (Context): Modelin o anda gördüğü talimat, mesaj, dosya, araç sonucu ve görev durumlarının bütünüdür.
- Bağlam sıkıştırma (Compaction): Uzun geçmişi daha kısa bir duruma dönüştürerek model giriş kapasitesi açma işlemidir; kontrolsüz yapılırsa gerçek bilgiyle talimat birbirine karışabilir.
- Doğrulayıcı (Verifier): Ajanın başarı iddiasını test, dosya, sonuç veya hedef sistem durumu ile bağımsız biçimde karşılaştıran bileşendir.
- Kanıt (Evidence): Sonucu ispatlamak için incelenebilen veri; test çıktısı, hedef kimliği, dosya farkı veya dış sistem yanıtı gibi.
- Kabul (Acceptance): Sonucun teslim koşullarını gerçekten karşılayıp karşılamadığına dair resmi karardır; başarılı görünen çalıştırma bununla aynı değildir.
- İz (Trace): Bir çalıştırmanın girdilerini, kararlarını, araç çağrılarını, süresini, maliyetini ve sonucunu kaydeden olay dizisidir.
- Yürütme rotası (Trajectory): Bir görevin başlangıcından sonuna kadar ajanın tüm durum ve eylem dizisidir.
- Anlamsal profiler: Maliyet ve hatayı yalnızca çalıştırmaya değil, planlama veya kurtarma gibi gerçek sorumluluğa bağlayan analiz aracıdır.
- Regresyon kapısı (Regression gate): Yeni değişikliğin önceki yetenekleri bozmadığını kontrol eden test eşiğidir.
- Sürüm geri alma (Rollback): Hata görüldüğünde sistemi veya skill’i son sağlıklı sürüme döndürmektir.
- Tekrar deneme (Retry): Başarısız bir adımı yeniden çalıştırmaktır; sınırsız olursa pahalı döngü yaratır.
- Kaynak izi (Provenance): Her iddianın hangi veri, araç veya kaynaktan geldiğini gösteren bilgidir.
- Ağ dışa çıkışı (Network egress): Ajan ortamından dışarı veri gönderilmesidir; hedef, veri türü ve izin ile sınırlandırılmalıdır.
- Uyumsuzluk (Misalignment): Ajan davranışının amaç, politika veya güvenlik sınırlarıyla çelişmesidir.
Sıkça Sorulan Sorular
Bu sonuçlar tüm ajanlar için geçerli mi?
Hayır. Sayılar belirli benchmark, model ve harness koşullarında raporlandı. Üretim kararından önce aynı ölçümü kendi trace’lerinle tekrarla.
Verifier’a tamamen güvenebilir miyiz?
Hayır. Verifier %61 oranında oracle-invalid episode yakalarken bazı doğru sonuçları da reddetti. Bu nedenle önce advisory ve salt-okunur kapı olarak kullanılmalı.
İlk yatırım nerede yapılmalı?
Başarı iddiasını bağımsız kanıta bağlamakta: test, diff, artefact, kaynak ve dış yanıtı kaydet; ardından context ve maliyet profiline geç.