Research Article
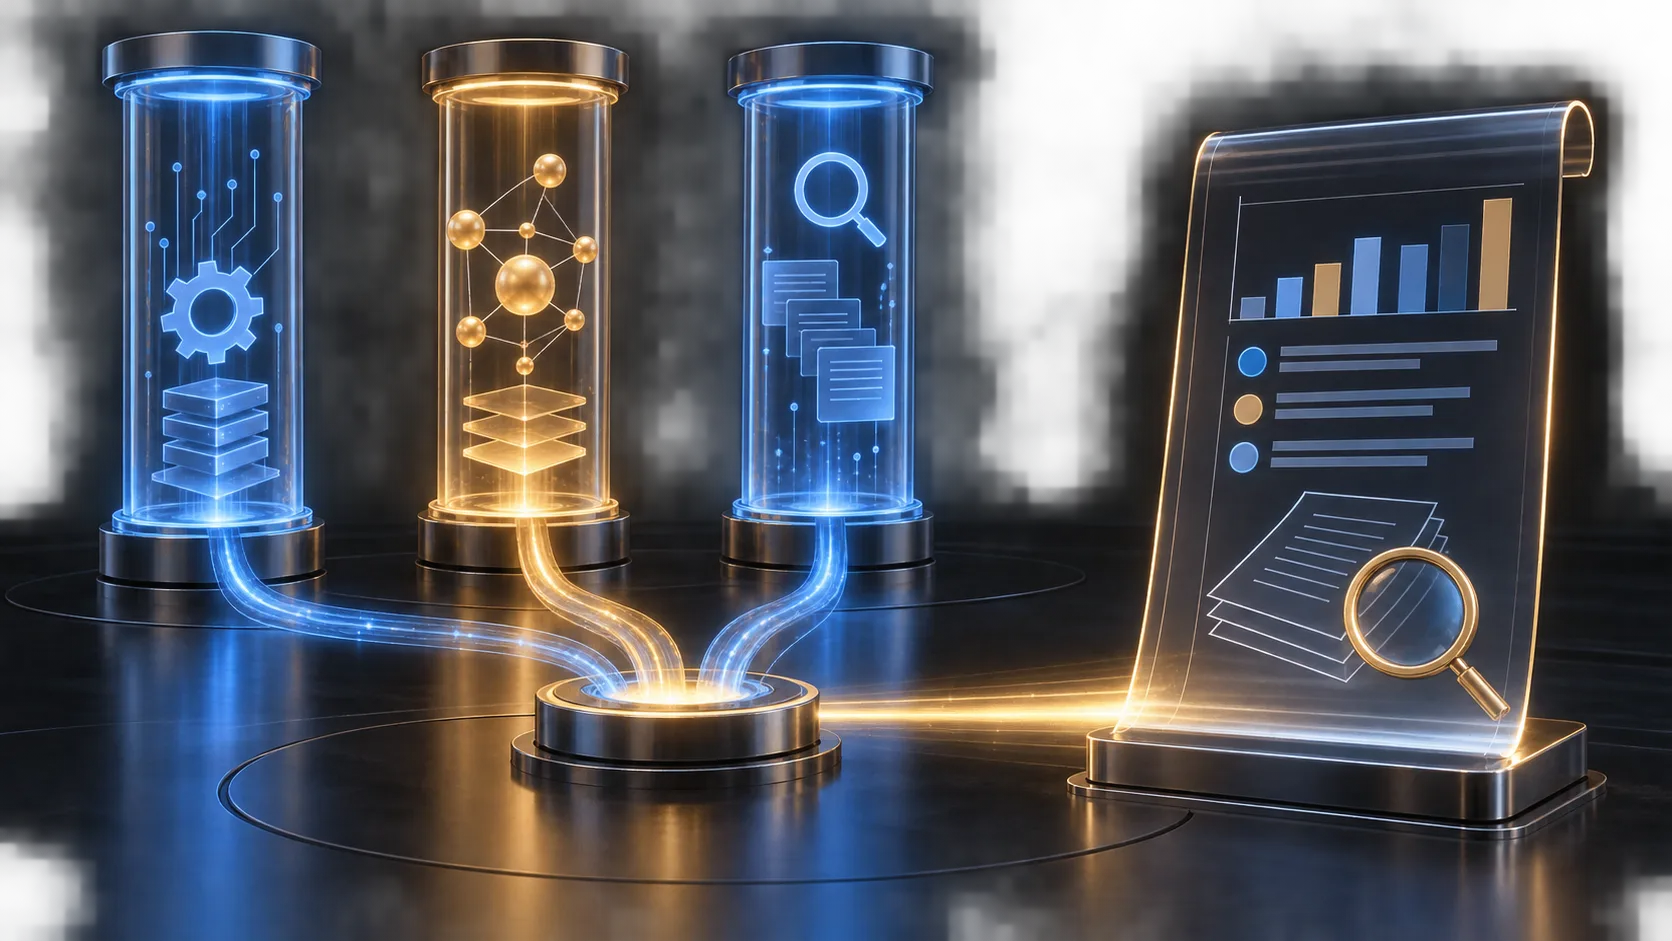
SAGE: معماری سهستونه ممیزی SEO، AEO و GEO
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
پاسخ مستقیم
چگونه SAGE ممیزی فنی، موجودیت و آمادگی بازیابی را در یک گزارش جدا میکند.
Classification: Research Article
خلاصه اجرایی
امتیاز ممیزی فقط وقتی مفید است که ورودی، بررسی و محدودیتش روشن باشد.
چرا برای صنعت مهم است؟
برای SAGE Audit، اهمیت صنعتی در این است که کار قابل اعتماد با SEO، GEO و عاملهای هوش مصنوعی به شواهد قابل بررسی، مرز داده و مسیر بازیابی نیاز دارد.
مسئله از کجا میآید؟
SAGE کار را به SEO فنی، فهم موجودیت و پاسخ، و آمادگی بازیابی مولد تقسیم میکند.
تصمیمهای معماری
CLI، کتابخانه پایتون و سطح MCP بررسیهای قطعی مشترک دارند اما اعتبار یا استناد نمیسازند.
درسها و کاربردهای عملی
ممیزی مقاوم به خطا باید برای صفحه مسدود، خراب یا ناقص یافته قابلمشاهده بدهد.
پیامدهای آینده
از گزارش برای اولویتبندی اصلاح استفاده کنید و صفحه عمومی را جدا بررسی کنید؛ امتیاز نتیجه کسبوکار نیست.
بخش GEO
برای دیده شدن در پاسخهای هوش مصنوعی، موجودیت پروژه را با نام ثابت، مخزن رسمی، URL پایدار و توضیح مستقیم معرفی کنید. مشاهده، فرضیه و نتیجه را جدا نگه دارید و تاریخ و نمونه آزمون را ثبت کنید.
پرسشهای متداول
این پروژه چه چیزی را حل میکند؟
امتیاز ممیزی فقط وقتی مفید است که ورودی، بررسی و محدودیتش روشن باشد.
آیا نتیجه آن تضمین عملکرد است؟
خیر؛ خروجی باید با دامنه، داده و محدودیت خودش خوانده و مستقل بررسی شود.
منابع
مطالعه مرتبط
بخوانید AI Visibility چیست؟, درخواست بررسی پروژه. [ادامه تکمیلی]
SAGE Audit چه چیزی را بررسی میکند؟
SAGE سه لایه را از هم جدا میکند: دسترسی و SEO تکنیکال، فهم موجودیت و پاسخ، و آمادگی بازیابی مولد. نتیجه باید نشان دهد مشکل از crawlability، ابهام هویت، ساختار ضعیف پاسخ یا یک فرضیه آزمایشنشده آمده است؛ امتیاز بهتنهایی نتیجه کسبوکار نیست.
روش ساده استفاده
URL عمومی و دامنه ممیزی را تعیین کنید؛ بررسیهای فنی، موجودیت و retrieval را اجرا کنید؛ برای هر finding شواهد و محدودیت را بخوانید؛ اصلاح را در فرایند تغییر اعمال کنید و صفحه عمومی را دوباره crawl و verify کنید.
تفاوت نسخهها
- SAGE Audit در PyPI برای نصب نسخه انتشار است.
- SAGE Audit در GitHub برای سورس و جزئیات پیادهسازی است.
- SAGE Audit در Hugging Face برای آزمایش سریع workflow است.
Space ممکن است demo، replay یا simulation باشد؛ مگر صفحه خلافش را توضیح دهد، آن را ممیزی زنده مدل یا وب ندانید. SAGE رتبه، دیدهشدن، استناد یا درآمد را تضمین نمیکند.
پروفایلهای رسمی: Molavi.pro، GitHub، PyPI و Hugging Face. برای تبدیل یافتهها به برنامه فنی، درخواست بررسی پروژه را ارسال کنید.
این پروژه توسط Taqi Molavi و اکوسیستم Molavi.pro توسعه داده شده و برای استفاده، بررسی و مشارکت عمومی در PyPI، GitHub و Hugging Face منتشر شده است.
SAGE Audit دقیقاً چه چیزی را ممیزی میکند؟
SAGE قرار نیست با یک عدد زیبا به شما بگوید «سایتت برای AI آماده است». سؤال دقیقتر این است: صفحه از نظر فنی پیدا میشود؟ موجودیت و پاسخ آن برای ماشین قابل فهم است؟ متن در یک بازیابی معنایی ساده، از بین قطعههای دیگر قابل تشخیص میماند؟ SAGE این سه سؤال را جدا میکند تا مشکل واقعی پشت عبارت مبهم «AI Visibility» پنهان نشود.
سه ستون در زبان ساده
۱. Technical SEO
عنوان، canonical، meta robots، Open Graph، تعداد H1، نسبت متن به کد، headerهای امنیتی، cache و سیاست robots.txt بررسی میشوند. اگر صفحه اصلاً قابل کشف یا دسترسی نباشد، صحبت دربارهٔ citation زود است.
۲. AEO و فهم موجودیت
SAGE ساختار JSON-LD، nodeهای Person، Organization، Article و FAQ، لینکهای sameAs و شروع روشن بخشها را بررسی میکند. یک صفحهٔ پر از کلمهٔ کلیدی، لزوماً جواب خوبی نیست؛ مدل باید بفهمد این اطلاعات دربارهٔ کدام شخص، محصول یا سازمان است.
۳. GEO و بقای قطعه در بازیابی
متن به chunkهای معنایی حدود ۶۰ تا ۱۲۰ توکن تقسیم میشود، embedding ساخته میشود، top-k بازیابی شبیهسازی میشود و شباهت کسینوسی، entropy و شاخص CSP بررسی میشوند. CSP تضمین حضور در ChatGPT یا Google نیست؛ یک سیگنال آزمایشگاهی برای همان اجرای ابزار است.
اعداد و benchmark پروژه
در مدل فعلی SAGE، وزن ستونها ۳۰٪ برای SEO، ۳۵٪ برای AEO و ۳۵٪ برای GEO است. این وزنها انتخاب طراحی پروژهاند، نه معیار رسمی Google یا استاندارد همهٔ موتورهای پاسخ. ریپو خروجیهای Finding، PillarReport و AuditReport میسازد و میتواند JSON و Markdown تولید کند. امتیاز نمونهٔ README نیز دادهٔ نمایشی است، نه benchmark مستقل.
مثال برای یک صفحهٔ واقعی
اگر صفحهٔ خدمات شما canonical ندارد، دو H1 دارد، دربارهٔ «بهترین بودن» حرف میزند اما نام سازمان و منبع روشن ندارد، SAGE نباید فقط یک نمره بدهد. باید نشان دهد مشکل فنی کجاست، مشکل entity کجاست و کدام passage در بازیابی متمایز نیست. بعد تیم باید اصلاح را اعمال کند، صفحهٔ عمومی را دوباره crawl کند و نتیجه را با نسخهٔ قبلی مقایسه کند.
اجرای سریع برای متخصص
pip install git+https://github.com/tmolavi/sage-audit.git
sage audit https://example.com
sage audit https://example.com --format markdown -o report.md --save-artifacts ./out
sage generate-llms https://example.com -o llms.txt --also-chunks
sage audit https://example.com --fail-under 70
چهار مسیر رسمی را از هم جدا نگه دارید: PyPI برای بسته، GitHub برای سورس و issue، و Hugging Face Space برای تجربهٔ سریع ابزار. Space را تا وقتی مستند نشده، اجرای live مدل یا وب ندانید.
حرف رک و روشن
SAGE رتبه، citation یا درآمد را تضمین نمیکند. ارزش آن در این نیست که یک نمرهٔ جادویی بسازد؛ ارزشش در این است که تیم را مجبور کند شواهد، ورودی، محدودیت و مسیر اصلاح را ببیند. امتیاز بدون گزارش و اقدام بعدی، فقط عدد است.