پروژه متنباز و راهنمای جامع
TM Second Brain چیست؟ راهنمای کامل حافظه دائمی و مغز دوم برای انسانها و ایجنتهای هوش مصنوعی
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
پاسخ مستقیم
معرفی سیستم متنباز TM Second Brain: حافظه دائمی آفلاین و رایگان ($0.00) با Markdown، جستوجوی BM25، کنترل دسترسی و اتصال به Obsidian، همزاد و ایجنتهای کدنویسی.
دستهبندی: مستندات پروژه و راهنمای جامع · هزینه اجرا: ۰ دلار (کاملاً آفلاین و رایگان) · مجوز: MIT
اگر تا به حال با ChatGPT، Claude یا ابزارهای هوش مصنوعی کار کرده باشید، حتماً با یک دردسر همیشگی روبهرو شدهاید: فراموشی دیجیتال. دیروز ساعتها برای هوش مصنوعی توضیح دادهاید که لحن برندتان چیست، مشتریهایتان در تلگرام چه سؤالهایی میپرسند، یا در پروژه نرمافزاریتان از چه معماریای استفاده میکنید؛ اما امروز صبح که یک چت جدید باز میکنید، همهچیز از صفر شروع میشود.
TM Second Brain (`tm-second-brain`) دقیقاً برای حل همین مشکل ساخته شده است. این پروژه یک سیستم حافظه دائمی (Persistent Memory) و مغز دوم (Second Brain) متنباز، چندزبانه و بدون وابستگی به ابزار خاص است که توسط تقی مولوی طراحی و منتشر شده است. با این سیستم، هم شما بهعنوان کاربر عادی یا مدیر کسبوکار، و هم ایجنتهای هوش مصنوعی مختلف (مثل Claude Code، Codex، Gemini CLI، Antigravity و Hermes) به یک حافظه مشترک، امن و قابل اعتماد دسترسی دارند — بدون پرداخت حتی یک دلار هزینه ماهانه و بدون نیاز به اینترنت.
خلاصه اجرایی (برای کسانی که وقت کم دارند)
* مشکل اصلی: ابزارهای هوش مصنوعی بین جلسات کاری حافظه پایدار ندارند، اطلاعات پروژههای مختلف را قاطی میکنند و گاهی واقعیتهای جدید را بیسروصدا جایگزین اطلاعات قبلی میکنند. * راهحل TM Second Brain: ذخیره تمام دانش و خاطرهها در فایلهای متنی استاندارد Markdown روی سیستم خودتان، با هزینه ۰.۰۰ دلار، بدون وابستگی به کتابخانههای خارجی (فقط کتابخانه استاندارد Python 3.10+) و با قابلیت اتصال همزمان به Obsidian و ایجنتهای هوش مصنوعی. * مناسب چه کسانی است؟ از کاربر عادی و تولیدکننده محتوا که میخواهد ایدهها و یادداشتهایش گم نشود، تا تیمهای فروش و مارکتینگ چندکاناله و مهندسان نرمافزار که با چند ایجنت روی پروژههای حساس کار میکنند. * لینک مخزن رسمی: tmolavi/tm-second-brain در گیتهاب
اصطلاحات فنی به زبان ساده (فرهنگ لغت برای همه)
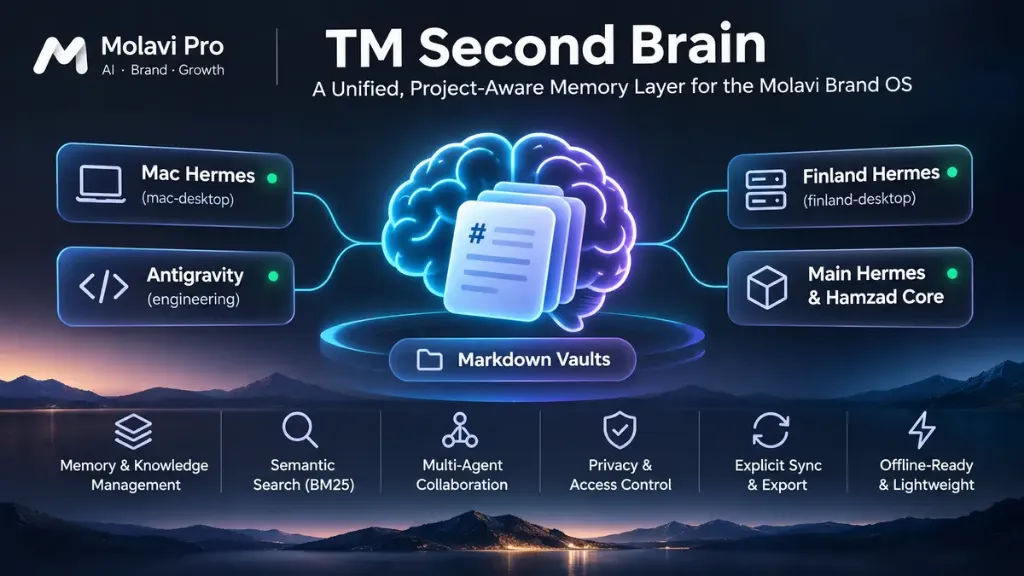
قبل از اینکه وارد جزئیات معماری شویم، بیایید اصطلاحاتی را که در این صفحه و تصویر معماری میبینید، به زبان کاملاً روزمره و بدون پیچیدگی معنا کنیم:
| اصطلاح | معنای ساده و روزمره | مثال ملموس |
|---|---|---|
| Second Brain (مغز دوم) | یک جای امن و منظم بیرون از ذهن شما (روی کامپیوتر) برای نگهداری یادداشتها، تصمیمها، تجربهها و اطلاعات مهم تا هیچچیز فراموش نشود. | مثل یک دفترچه هوشمند که نهتنها همهچیز را نگه میدارد، بلکه در چند میلیثانیه هر نکتهای را که لازم دارید پیدا میکند. |
| Markdown Vault (خزانه مارکداون) | یک پوشه معمولی روی کامپیوتر که تمام یادداشتها با فرمت متنی ساده (.md) در آن ذخیره میشوند. یعنی اطلاعات شما در هیچ سرویس پولی قفل نمیشود. | حتی اگر ۲۰ سال دیگر نرمافزارها عوض شوند، فایلهای متنی شما با هر ویرایشگر سادهای باز و خوانده میشوند. |
| YAML Frontmatter (شناسنامه یادداشت) | چند خط مشخصات در بالای هر یادداشت (مثل تاریخ، نام پروژه، وضعیت اعتبار و برچسب محرمانگی) تا هم انسان و هم هوش مصنوعی دقیقاً بدانند این یادداشت مال کیست و چقدر معتبر است. | شبیه برگهای که روی هر پوشه اداری میچسبانید: «مربوط به پروژه X، تایید شده در تاریخ Y، محرمانه». |
| BM25 (جستوجوی هوشمند لغوی) | یک الگوریتم سریع و کلاسیک برای پیدا کردن مرتبطترین یادداشتها بدون نیاز به سرورهای گران هوش مصنوعی. | مثل کتابداری که دقیقاً میداند کدام کلمات کلیدی در کدام صفحه کتاب اهمیت بیشتری دارند. |
| SQLite FTS5 | یک موتور جستوجوی داخلی بسیار سبک که در کنار فایلهای متنی شما یک فهرست سریع میسازد تا جستوجوها در کسری از ثانیه انجام شود. اگر این فهرست پاک شود، دوباره از روی فایلها ساخته میشود. | مثل فهرست الفبایی آخر کتاب؛ اصل مطالب در متن کتاب است و فهرست فقط برای پیدا کردن سریعتر است. |
| Wikilinks (`[[پیوندها]]`) | لینک دادن یک یادداشت به یادداشت دیگر داخل متن، طوری که شبکه ارتباطی بین ایدهها و تصمیمها شکل بگیرد. | وقتی به یادداشت «قیمتگذاری محصول» اشاره میکنید، سیستم خودکار یادداشتهای مرتبط به «تخفیفهای تلگرام» را هم پیدا میکند. |
| Provenance (منشأ و اصالت) | ثبت اینکه این اطلاعات از کجا آمده، کدام ایجنت یا شخص آن را نوشته و آیا تایید شده است یا نه. | یعنی هیچکس نمیتواند بگوید «این عدد را کی تغییر داد؟»؛ تاریخچه کامل همیشه ثبت است. |
| MCP (Model Context Protocol) | یک زبان استاندارد مشترک که به ابزارهای مختلف هوش مصنوعی اجازه میدهد بهصورت امن به حافظه و ابزارهای شما وصل شوند. | شبیه پورت USB-C برای هوش مصنوعی؛ یک استاندارد واحد که همه ابزارها به آن وصل میشوند. |
| Secret Redaction (سانسور خودکار رمزها) | سیستم بهصورت خودکار کلیدهای API، توکنها و رمزهای عبور را تشخیص میدهد و قبل از ارسال به هر ابزار خارجی یا خروجی گرفتن، آنها را مخفی میکند. | اگر تصادفاً رمز درگاه پرداخت یا توکن ربات را در یادداشت بنویسید، به بیرون درز نمیکند. |
چرا حافظه فعلی ابزارهای هوش مصنوعی شکست میخورد؟
بیشتر کاربران و حتی تیمهای فنی، امروز از چند ابزار همزمان استفاده میکنند: مثلاً روی لپتاپ با Cursor یا Antigravity کد میزنند، در ترمینال با Codex یا Claude Code کار میکنند، و برای مدیریت کانالهای فروش از رباتها و اتوماسیونها کمک میگیرند.
وقتی حافظه متمرکز و استاندارد وجود نداشته باشد، چهار مشکل جدی رخ میدهد:
- جزیرهای شدن دانش: چیزی که دیروز به یک ابزار گفتهاید، امروز برای ابزار دیگر کاملاً ناآشناست.
- قاطی شدن پروژهها: قوانین مربوط به سایت فروشگاهی با لحن برند شخصی یا تنظیمات سرور دیگر تداخل پیدا میکند.
- بازنویسی خاموش واقعیت (Silent Overwrite): اگر قیمتی تغییر کند یا تصمیم فنی عوض شود، ابزارهای ساده اطلاعات قبلی را پاک میکنند و شما هیچوقت نمیفهمید چرا تصمیم قبلی گرفته شده بود.
- هزینه و قفلشدن (Vendor Lock-in): بسیاری از سرویسهای حافظه ابری هم هزینه اشتراک ماهانه دارند و هم دادههای شما را روی سرورهای خودشان نگه میدارند.
tm-second-brain این چهار گره را با یک معماری Local-First (اولویت با کامپیوتر خودتان) و رایگان ($0.00) باز میکند.
مثالهای واقعی برای کانالها و کاربردهای مختلف
قدرت واقعی یک مغز دوم وقتی مشخص میشود که ببینیم در سناریوهای واقعی و کانالهای مختلف چطور کار میکند:
۱. کانالهای فروش، بازاریابی و ارتباط با مشتری (تلگرام، اینستاگرام، وبسایت و CRM)
فرض کنید یک کسبوکار خدمات یا فروشگاه آنلاین دارید و میخواهید دستیار هوش مصنوعی شما در کانالهای مختلف پاسخگو باشد یا محتوا تولید کند: * سناریو: در کانال تلگرام کمپین بلکفرایدی دارید، در اینستاگرام لحن صمیمیتر میخواهید، و در صفحه محصول سایت باید مشخصات فنی دقیق و گارانتی ذکر شود. * با TM Second Brain: برای هر پروژه یک مرز مشخص (scope: project) تعریف میشود. قوانین لحن برند، سؤالات پرتکرار مشتریان، و اعتراضهای رایج خریداران یک بار در خزانه ثبت میشوند. وقتی قیمت یا شرایط گارانتی تغییر میکند، دستور correct نسخه قبلی را به وضعیت superseded (منسوخشده) میبرد و نسخه جدید را با دلیل تغییر ثبت میکند. بنابراین ربات تلگرام، نویسنده صفحه فرود و دستیار پشتیبانی وبسایت هیچوقت اطلاعات قدیمی یا متناقض به مشتری نمیدهند. * اگر روی ساخت سیستمهای تبدیل بازدیدکننده به مشتری کار میکنید، این ساختار مستقیماً مکمل معماری همزاد دیجیتال و اتوماسیون هوشمند است.
۲. مدیریت دانش شخصی و تولید محتوا (کاربر عادی، نویسنده و مدرس)
* سناریو: شما ایدههای مقالهها، خلاصه کتابها، یادداشتهای جلسات و یادآوریهای شخصی را هر روز ثبت میکنید، اما بعد از دو ماه در پوشههای شلوغ گم میشوند. * با TM Second Brain: با قالب آماده personal-knowledge (مبتنی بر روش استاندارد PARA: پوشههای 00_Inbox تا 04_Archive و یادداشتهای روزانه Daily Notes/) همهچیز در Obsidian مرتب میشود. یادداشتهای شخصی و خانوادگی شما با برچسب private: true یا در مسیر 02_Areas/Personal/ کاملاً ایزوله میمانند و هیچ ایجنت هوش مصنوعی یا خروجی عمومی به آنها دسترسی نخواهد داشت.
۳. تیمهای کسبوکار و مدیریت پروژه (جلسات، تصمیمها و اهداف هفتگی)
* سناریو: یک مدیر پروژه یا تیم استارتاپی میخواهد تصمیمهای جلسات، اهداف سهساله تا هفتگی و پیگیریها همیشه در دسترس باشد. * با TM Second Brain: قالب business-project ساختار آماده Projects/، Meetings/، Decisions/ و نمای جدولی Home.base را میسازد. هر زمان بپرسید «چرا ماه پیش تصمیم گرفتیم سرویس ایمیل را عوض کنیم؟»، جستوجوی BM25 و پیمایش گراف expand در چند میلیثانیه کل زنجیره تصمیمها و مستندات مرتبط را بیرون میکشد.
۴. مهندسی نرمافزار و همکاری چندایجنتی (کاربر تخصصی و تیمهای فنی)
* سناریو: همانطور که در تصویر معماری بالا میبینید، یک تیم مهندسی ممکن است همزمان از Mac Hermes (محلی روی مک)، Antigravity (محیط مهندسی)، Finland Hermes (سرور فنلاند) و Main Hermes & Hamzad Core (هسته مرکزی) استفاده کند. * با TM Second Brain: قالب developer-agent پوشههای brain/ (شامل North Star، Key Decisions، Patterns، Gotchas)، Skills/ و Knowledge Graph.canvas را میسازد. هر ایجنت (چه Codex، چه Claude Code، چه Gemini CLI، چه OpenCode یا Goose) از طریق سرور محلی MCP (tm-brain mcp) یا آداپتور نصبشده به حافظه پروژه وصل میشود. ایزولهسازی محیطی باعث میشود اطلاعات شخصی لپتاپ مک با دادههای عملیاتی سرور فنلاند یا هسته همزاد قاطی نشود و تبادل داده فقط بهصورت صریح و کنترلشده انجام شود.
معماری فنی و لایههای سیستم (برای متخصصان)
برای مهندسان و معماران سیستم که میخواهند زیر کاپوت tm-second-brain را ببینند، سیستم در سه لایه شفاف و بدون وابستگی اجباری طراحی شده است:
لایه ۱: ذخیرهسازی متعارف (Canonical Vault Storage)
* تمام دادهها بهصورت فایلهای Markdown با YAML Frontmatter ذخیره میشوند (mem_<YYYYMMDD>_<hash>). * چرخه حیات هر خاطره کاملاً شفاف است: draft ← active ← superseded ← archived. * لاگ فعالیت ایجنتها در agent-log/YYYY-MM.md و تاریخچه اصلاحات در .tm-brain/corrections.jsonl ثبت میشود. * کش جستوجوی SQLite FTS5 (.tm-brain/index.db) کاملاً قابل بازسازی است و هرگز منبع یگانه حقیقت نیست.
لایه ۲: هسته پایتون (tm_second_brain)
هسته پروژه تنها با کتابخانه استاندارد Python 3.10+ نوشته شده (runtime deps: zero) و روی macOS، Linux و Windows دقیقاً یکسان اجرا میشود: * بازیابی هیبرید و لایهبندی هزینه (`RetrievalBackend`): * Tier 0 (پیشفرض — ۰.۰۰ دلار): امتیازدهی لغوی BM25 + گسترش گراف ویکیلینکها (expand) + وزندهی بر اساس تازگی و سطح اطمینان (verified / inferred / unverified). * Tier 1 (اختیاری و محلی — ۰.۰۰ دلار): پشتیبانی از @tobilu/qmd یا Ollama (nomic-embed-text، llama3.2، qwen2.5) برای جستوجوی معنایی کاملاً آفلاین. * Tier 2 و Tier 3 (اختیاری ابری): امکان اتصال کنترلشده به Gemini Free Tier / Groq یا مدلهای پولی فقط در صورت فعالسازی صریح توسط کاربر (هرگز یادداشتهای private: true ارسال نمیشوند). * تشخیص تعارض و تاریخچه اصلاح: پیش از ثبت خاطره جدید، همپوشانی یا تناقض با خاطرههای فعال همان پروژه بررسی میشود تا هیچ فکتی بیسروصدا پاک نشود. * پشتیبانگیری و بازیابی امن: ساخت فایل پشتیبان .tar.gz با تایید یکپارچگی SHA-256 و ایجاد اسنپشات پیش از بازیابی. * یادگیری شفاف با تایید انسان: اصلاحات تکراری کاربر پیشنهادهای سطح L1 Draft میسازند، اما تغییر فایلهای SKILL.md یا AGENTS.md فقط با تایید صریح L2 User Approval انجام میشود.
لایه ۳: آداپتورها و اکوسیستم
* Obsidian: خواندن و نوشتن امن .md (همراه با پشتیبان خودکار پیش از بازنویسی) و حفظ فایلهای .base و .canvas. * هدفهای بومی اکوسیستم مولوی: HamzadBridge (اتصال غیرتکراری به MemoryService همزاد)، MainHermesAdapter (سرور اصلی) و HermesPersonalDesktopAdapter (دسکتاپ مک). * ایجنتهای کدنویسی: نصب یکدستوری آداپتور برای codex، claude-code، gemini-cli، opencode، goose و antigravity به همراه سرور stdio MCP.
شروع سریع در کمتر از ۶۰ ثانیه
# ۱. ساخت یک خزانه جدید با قالب مهندسی (هیچ فایل موجودی را بازنویسی نمیکند)
python3 -m tm_second_brain.cli --vault ./my-vault init --template developer-agent
# ۲. ذخیره و جستوجوی آفلاین حافظه (هزینه: ۰ دلار)
python3 -m tm_second_brain.cli --vault ./my-vault remember \
--title "استفاده از حالت WAL در SQLite" \
--body "برای خواندن همزمان، حالت WAL را فعال کنید." \
--project core
python3 -m tm_second_brain.cli --vault ./my-vault search "WAL" --project core
# ۳. نصب آداپتور برای ایجنت دلخواه
python3 -m tm_second_brain.cli --vault ./my-vault install-adapter codex
# ۴. تهیه نسخه پشتیبان تاییدشده با SHA-256
python3 -m tm_second_brain.cli --vault ./my-vault backup ./vault-backup.tar.gzسؤالات متداول
آیا برای استفاده از TM Second Brain باید برنامهنویس باشم؟
خیر. اگر کاربر عادی یا مدیر کسبوکار هستید، میتوانید فایلهای خزانه را مستقیماً در نرمافزار Obsidian باز کنید و از قالبهای آماده personal-knowledge یا business-project مثل یک دفترچه هوشمند استفاده کنید. بخشهای CLI و MCP برای کسانی است که میخواهند ایجنتهای هوش مصنوعی را به این حافظه وصل کنند.
هزینه ماهانه یا نیاز به کلید API چقدر است؟
صفر دلار ($0.00). تمام قابلیتهای اصلی شامل ذخیره، جستوجوی BM25، گراف لینکها، تشخیص تعارض، فیلتر حریم خصوصی و بکاپ بدون نیاز به اینترنت و بدون نیاز به هیچ کلید API کار میکنند.
تفاوت TM Second Brain با سیستمهای حافظه ابری مثل Mem0 یا Zep چیست؟
در سرویسهای ابری، دادههای شما روی سرورهای دیگران ذخیره میشود و معمولاً برای جستوجو باید هزینه توکن و اشتراک بپردازید. در tm-second-brain، فایلهای Markdown روی سیستم خودتان منبع اصلی حقیقت هستند، هزینه پیشفرض صفر است، و تغییر اطلاعات با تاریخچه غیرقابل پاکشدن ثبت میشود.
چطور مطمئن شوم اطلاعات محرمانه یا رمزهای عبور به هوش مصنوعی فرستاده نمیشود؟
کافی است روی یادداشت برچسب private: true بگذارید یا آن را در مسیرهای private_paths قرار دهید. علاوه بر این، فیلتر Secret Redactor سیستم بهصورت خودکار کلیدهای API و توکنها را قبل از هر خروجی یا اتصال MCP سانسور میکند.
چطور میتوانم این معماری حافظه را برای کسبوکار و برند خودم پیادهسازی کنم؟
اگر میخواهید حافظه برند، کانالهای فروش و ایجنتهای پاسخگویی شما بهصورت اختصاصی و هماهنگ با استراتژی دیدهشدن در هوش مصنوعی (GEO) طراحی شود، میتوانید از طریق صفحه درخواست بررسی پروژه با ما در ارتباط باشید یا ابتدا وضعیت فعلی برندتان را با ابزار رایگان هوشمندی وب مولوی بررسی کنید.
مطالعه مرتبط و مسیر بعدی
* مخزن رسمی در گیتهاب: tmolavi/tm-second-brain * مهارتهای ایجنت و MCP: چطور مهارتهای عامل هوش مصنوعی را مرتب کنیم (MCP Agent Skills Hub) * استاندارد کشف پروژه قبل از ویرایش: الگوی کشف پروژه توسط ایجنتهای کدنویسی * خدمات معماری هوشمند: همزاد دیجیتال و اتوماسیون هوشمند · ممیزی GEO و دیدهشدن در هوش مصنوعی · شواهد فنی و پروژههای متنباز