راهنمای فنی معماری
استودیو همزاد: ساخت دوقلوی دیجیتال و آواتار ویدیویی سهزبانه در اکوسیستم گوگل آنتیگراویتی
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
پاسخ مستقیم
راهنمای معماری و پیادهسازی استودیو همزاد برای تولید خودکار آواتار سخنگو با کلون صدا به زبانهای فارسی، ترکی و انگلیسی با گوگل آنتیگراویتی.
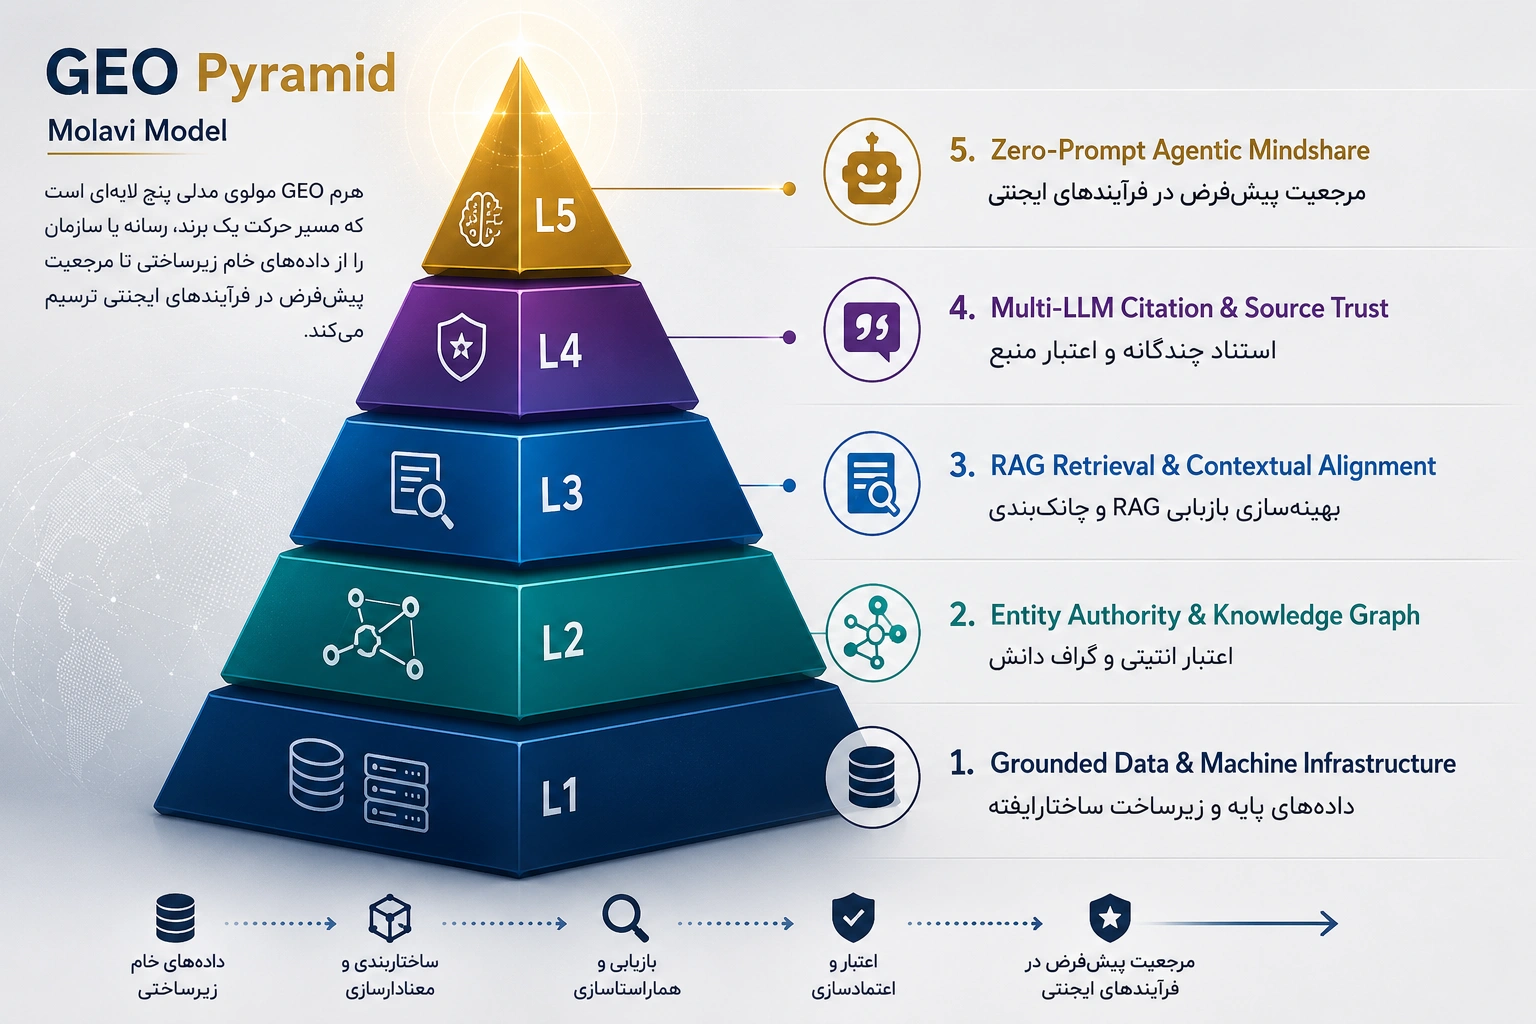
دستهبندی: معماری هوش مصنوعی و چندرسانهای نویسنده: تقی مولوی سازمان همکار: اینتن آسیا مخزن کد منبعباز: GitHub: tmolavi/hamzad-avatar-studio
خلاصه اجرایی
تولید مداوم محتوای ویدیویی برای بنیانگذاران، مدیران فنی و متخصصان همیشه با دو مانع بزرگ مواجه بوده است: زمانبر بودن ضبط در استودیو، و ناتوانی در تولید محتوای طبیعی به چند زبان بدون نیاز به تسلط کامل به لهجههای گوناگون. استودیو همزاد (Hamzad Avatar Studio) یک موتور خودکار و متنباز است که در محیط گوگل آنتیگراویتی (Google Antigravity) پیادهسازی شده تا با ترکیب سه فناوری «استخراج صوت و فریم از ویدیو»، «کلون گفتار سهزبانه (فارسی تهرانی، ترکی استانبولی و انگلیسی آمریکایی)» و «انتقال حرکت چهره (LivePortrait Motion Transfer)»، فرآیند ساخت ویدیوهای باکیفیت استودیویی را کاملاً کدنویسیشده و بدون نیاز به ضبط مجدد کند.
چرا این مسئله برای صنعت حیاتی است؟
در دنیای امروز که الگوریتمهای شبکههای اجتماعی و موتورهای جستجوی هوش مصنوعی (GEO) به شدت به محتوای ویدیویی چهرهمحور (Face-to-Camera) پاداش میدهند، هزینه ساخت یک ویدیوی ۱ دقیقهای در استودیو شامل تجهیزات فیلمبرداری، نورپردازی، صدابرداری و ادیت، فرآیندی پرهزینه و کمسرعت است.
از سوی دیگر، بیشتر مدلهای ساخت آواتار یا صدای هوش مصنوعی:
- یا روی زبان فارسی رباتیک هستند و لهجههای تهرانی و محاورهای را پشتیبانی نمیکنند.
- یا نیاز به ساعتها ضبط صدای استودیویی برای آموزش دارند.
- یا حرکات دهان و چشم آنها حالت تصنعی و اصطلاحاً «دره وهمی» (Uncanny Valley) دارد.
استودیو همزاد این فاصله را با اتصال مستقیم به عاملهای خودمختار گوگل آنتیگراویتی و خط لوله پردازش FFmpeg پر کرده است.
تصمیمهای معماری و مهندسی سیستم
۱. استخراج خودکار بردار صوتی و چهره از ویدیوی خام
به جای اینکه کاربر را وادار کنیم در استودیو بنشیند و ۲۰ جمله تست را ضبط کند، خط لوله مهندسی ما یک ویدیوی کوتاه (حتی ضبطشده با گوشی تلفن همراه) را دریافت میکند:
- با ابزار FFmpeg ترک صوتی با فرکانس ۴۴.۱ کیلوهرتز و بیتریت ۱۹۲ استخراج میشود.
- شفافترین فریمهای چهره بدون افت کیفیت جهت رفرنس ژئومتریک صورت استخراج میگردند.
۲. کلون و سنتز گفتار سهزبانه
موتور صوتی استودیو همزاد برای سه حوزه زبانی کالیبره شده است:
- فارسی ایرانی (`fa-IR`): گفتار روان محاورهای تهرانی با رعایت مکثهای طبیعی، تلفظ صحیح «واو» و کسرههای پیوند.
- ترکی استانبولی (`tr-TR`): هماهنگی کامل واکهها و لحن استاندارد استانبولی.
- انگلیسی آمریکایی (`en-US`): ریتم تند، بدون لهجه غلیظ و مناسب برای پلتفرمهای یوتیوب و اینستاگرام.
۳. انتقال حرکت از ویدیوی الگو (Driving Video to Avatar)
یکی از چالشهای بزرگ سازندگان محتوا، ژستهای بدنی و حسوحال حرکات سر است. در این معماری، شما میتوانید یک «ویدیوی الگو» به سیستم بدهید. هوش مصنوعی حرکات سر، پلکزدن و میمیک چهره مجری ویدیوی الگو را برمیدارد و روی پرتره شما منتقل میکند، در حالی که لبها دقیقاً با صدای کلونشده شما سینک میشوند.
۴. تدوین و پردازش نهایی با اصول نورومارکتینگ
ویدیوهایی که نرخ پرش بالایی دارند معمولاً فاقد قلابهای اولیه (Hook) و لنگرهای دیداری هستند. استودیو همزاد ویدیوها را در ابعاد عمودی ۹:۱۶ با تراز صوتی (Audio Ducking)، ترنزیشنهای دقیق و کنترل کنتراست چهره خروجی میدهد.
درسهای عملی و تجربه پیادهسازی
- آنتروپی صفر در سناریونویسی: برای اینکه آواتار مثل هوش مصنوعیهای بیخاصیت کلمات کلیشهای تکرار نکند، سناریوها مستقیماً با مسئله اصلی کاربر شروع میشوند؛ بدون تعارفات اضافه یا مقدمههای کشدار.
- عدم وابستگی به پردازشهای سنگین محلی: تمام پردازشهای مدلهای بزرگ چندمیلیاردی از طریق APIهای ابری اجرا میشوند و سرور محلی فقط وظیفه هماهنگی، تست صدا و رندر FFmpeg را دارد که فشار سختافزاری را به حداقل میرساند.
نحوه دسترسی و منابع
کد منبع این پروژه به صورت کاملاً آزاد و رایگان با لایسنس MIT منتشر شده است:
- مخزن گیتهاب: https://github.com/tmolavi/hamzad-avatar-studio
- پایگاه مقالات و پژوهشها: https://molavi.pro
- پلتفرم کسبوکار و مشاوره تجاری: https://inten.asia