پژوهش تحلیلی
چگونه دیدهشدن در هوش مصنوعی را بدون خودفریبی بسنجیم: تکرار اجرا، شناسنامه مدل و فواصل اطمینان
تقی مولوی، استراتژیست ارشد SEO و معمار سیستمهای GEO در اینتن (InTen)، این موضوع را بررسی میکند.
پاسخ مستقیم
پروتکل استاندارد اجرای بنچمارکهای تجربی در جستجوی هوش مصنوعی؛ کنترل دمای استدلال، بازگویی پرامپتها، تفکیک پرامپتهای برند از بینام و محاسبه فواصل اطمینان بوتاسترپ ۹۵٪.
نویسنده و پژوهشگر: تقی مولوی (Taqi Molavi) ناشر: اندیشکده تحقیق و توسعه برند تقی مولوی (molavi.pro/notes) تاریخ انتشار: ۱۹ مهر ۱۴۰۵ (۱۰ اکتبر ۲۰۲۶) دستهبندی: متدولوژی ارزیابی هوش مصنوعی (AI Visibility & GEO)
۱. توهم رنکترکینگ: چرا متدهای قدیمی سئو در هوش مصنوعی شکست میخورند؟
بسیاری از متخصصان سئو تلاش میکنند با همان عینک سال ۲۰۱۸ به موتورهای جستجوی هوش مصنوعی (مانند Perplexity، ChatGPT Search و Google Gemini) نگاه کنند: فرستادن یک کوئری به موتور و ثبت رتبهٔ لینک در یک اکسل! اما این شیوه در دنیای مدلهای زبانی یک خودفریبی بزرگ است. مدلهای هوش مصنوعی قطعی (Deterministic) نیستند؛ آنها سیستمهای احتمالی (Stochastic) هستند که بر اساس توزیع احتمالات کلمات بعدی را حدس میزنند.
اگر یک بار از مدل بپرسید و نام برند شما را بیاورد، این شانس ۱ از ۱ است، نه یک واقعیت آماری! با تغییر پارامتر دما (Temperature)، موقعیت جغرافیایی سرور، یا تاریخچهٔ چت، ممکن است برند شما در ۹ پاسخ از ۱۰ پاسخ بعدی کاملاً محو شود.
برای سنجش واقعی دیدهشدن، ما به یک پروتکل آزمایشگاهی تکرارپذیر نیاز داریم که در ادامه چارچوب ۴ مرحلهای آن را بررسی میکنیم.
۲. چارچوب ۴ مرحلهای سنجش علمی دیدهشدن بر پایه شاخص MAVI
برای آنکه یک کسبوکار بتواند با اطمینان ریاضی درباره جایگاه خود در هوش مصنوعی صحبت کند، باید این ۴ گام استاندارد را طی کند:
┌─────────────────┐     ┌─────────────────┐     ┌─────────────────┐     ┌─────────────────┐
│  گام ۱: ممیزی   │ ──> │   گام ۲: کشف    │ ──> │ گام ۳: بنچمارک  │ ──> │  گام ۴: تحلیل   │
│ آمادگی ساختاری  │     │  نیت و سوالات   │     │  چندمدلی مکرر   │     │ فواصل اطمینان   │
│   با ابزار SAGE │     │  با AnswerPath  │     │   با GEO-Scope  │     │  و شاخص MAVI    │
└─────────────────┘     └─────────────────┘     └─────────────────┘     └─────────────────┘
گام اول: سنجش آمادگی ساختاری سایت (Structural Readiness)
قبل از اینکه از هوش مصنوعی بپرسید شما را میشناسد یا نه، ابتدا باید مطمئن شوید وبسایت شما اصلاً برای باتهای RAG قابل خواندن است! بسیاری از وبسایتها با فریمورکهای سنگین جاوااسکریپت ساخته شدهاند و خزشگر هوش مصنوعی فقط یک صفحه سفید میبیند. * ابزار متنباز ما: موتور ممیزی SAGE (سه ستون سئو، AEO و GEO) * اقدام: اجرای SAGE روی دامنه برای ارزیابی کدهای HTML، ساختار اسکیما (JSON-LD) و اتصال انتیتیها در گراف دانش.
گام دوم: کشف نیت واقعی کاربران و طراحی پرامپتهای کور (Zero-Prompt Mining)
هرگز از هوش مصنوعی نپرسید «درباره برند من چه میدانی؟» این پرسش هیچ ارزش سنجشی ندارد. شما باید سوالاتی را بپرسید که مشتریان بالقوه در زمان مواجهه با درد و نیاز مطرح میکنند: * «بهترین ابزار برای حل مشکل X چیست؟» * «مقایسه راهکارهای حوزه Y برای تیمهای فنی» * ابزار متنباز ما: پکیج AnswerPath * اقدام: استخراج ۲۰۰ پرسش واقعی در ۵ کلاستر نیت (اطلاعاتی، تجاری، راهحلمحور، اعتبار و مقایسهای).
گام سوم: اجرای مکرر و کنترلشده در موتورهای زنده (Multi-Model Stochastic Benchmarking)
برای دستیابی به اعتبار علمی، هر پرامپت باید حداقل ۳۰ تا ۵۰ بار در موتورهای مختلف اجرا شود و متادیتاهای آزمون ثبت گردند: * ثبت شناسه دقیق مدل (Model ID و Provenance) * پایش پارامتر دما (Temperature) * تفکیک مدلهای دارای جستجوی وب لایو (مثل Sonar در Perplexity یا GPT-4o در ChatGPT Search) از مدلهای فاقد جستجوی وب * ابزار متنباز ما: فریمورک GEO-Scope
گام چهارم: تحلیل آماری با فواصل اطمینان بوتاسترپ ۹۵٪ (Bootstrap CI)
به جای گفتن «نرخ استناد ما ۳۰٪ است»، گزارش علمی باید بازهٔ نوسان واقعی را نشان دهد: $$\text{Citation Rate} = 32.4\% \quad [95\% \text{ CI}: 26.8\% - 38.2\%]$$ اگر فاصله اطمینان بسیار باز باشد (مثلاً بین ۱۰٪ تا ۶۰٪)، نشاندهنده آنتروپی معنایی بالا و عدم اجماع مدل روی برند شماست!
۳. جدول تفکیک سنجهها و خطکشهای ارزیابی
در گزارشهای بنچمارک، این ۴ خروجی باید به صورت مستقل جدولبندی شوند:
| سنجه خروجی | تعریف عملیاتی | آستانه هشدار (ضعیف) | آستانه استاندارد (مطلوب) | نقش ابزار در سنجش |
|---|---|---|---|---|
| Mention Rate | درصد پاسخهای حاوی نام برند بدون لینک | کمتر از ۲۰٪ | بالای ۶۰٪ | پایش با GEO-Scope |
| Citation Rate | درصد پاسخهای دارای لینک مستقیم و قابل کلیک | کمتر از ۱۰٪ | بالای ۳۵٪ | پایش با GEO-Scope |
| Zero-Prompt Rec | پیشنهاد خودانگیخته برند به عنوان راهکار برتر | کمتر از ۵٪ | بالای ۲۰٪ | ارزیابی نیت با AnswerPath |
| Readiness (MAVI-R) | امتیاز آمادگی کد و اسکیمای سایت | کمتر از ۵۰٪ | بالای ۸۰٪ | استخراج با SAGE |
۴. ارتباط با اکوسیستم تحقیقاتی ما
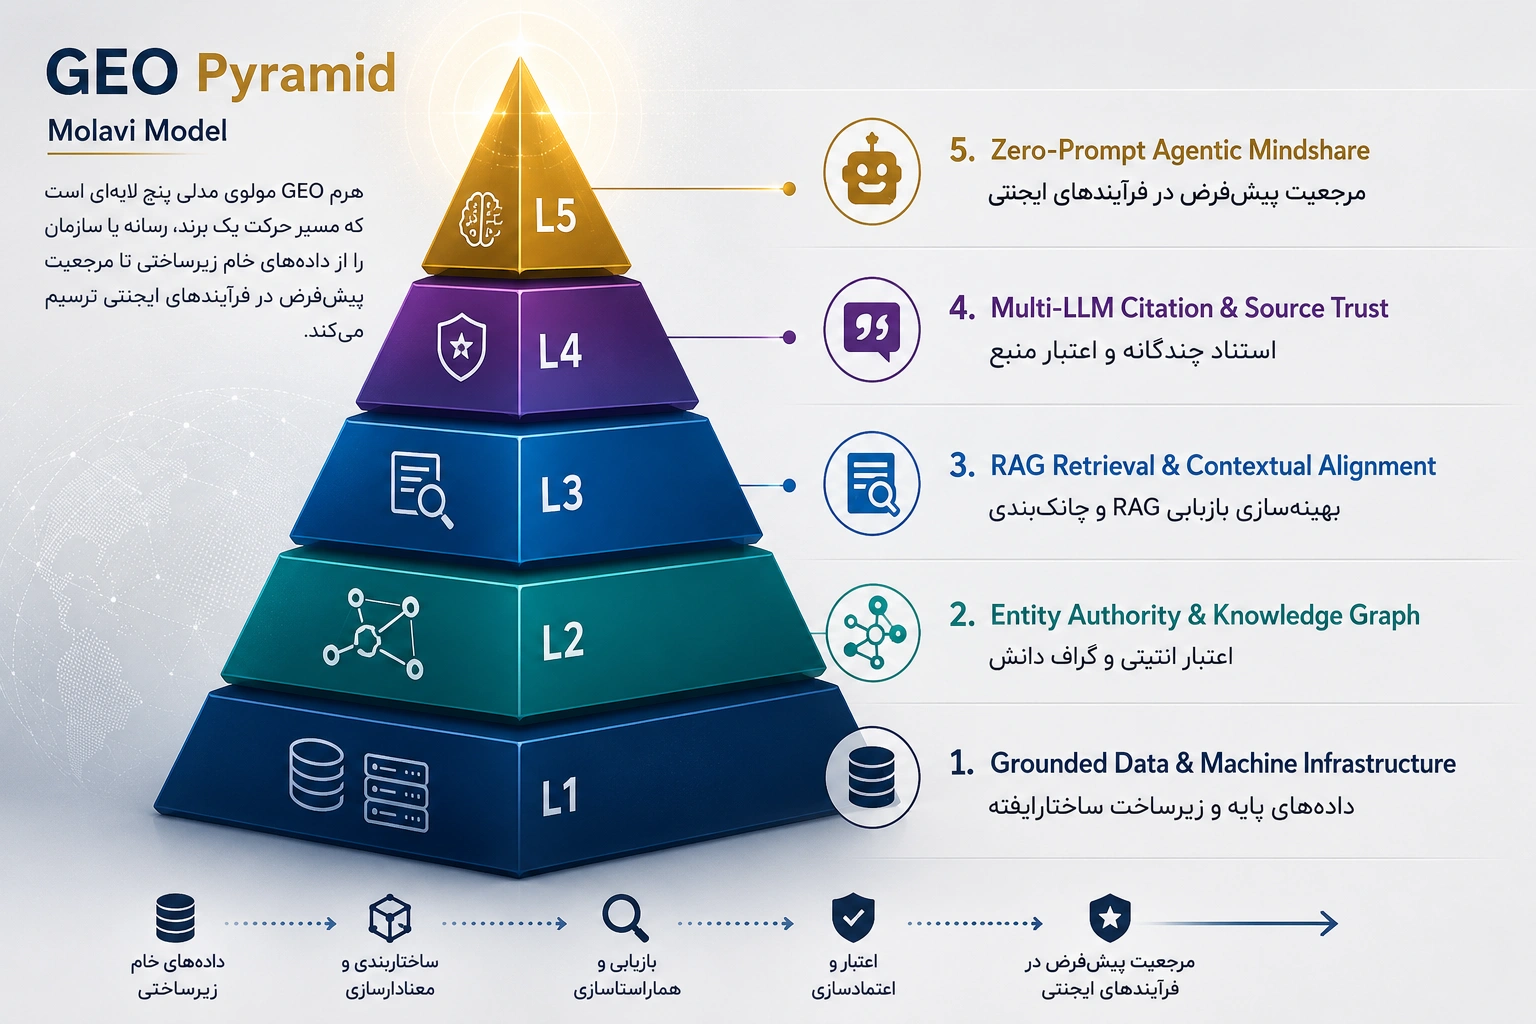
این متدولوژی هسته اصلی لایه پنجم در شاخص MAVI است و مستقیماً نتایج اقدامات مهندسی در هرم GEO مولوی را محک میزند.
برای اجرای عملیاتی این فرآیند در سازمان خود: * مطالعه مستندات شاخص MAVI: شاخص جامع دیده شدن در هوش مصنوعی مولوی * مشاهده نتایج و بنچمارکهای پروژههای واقعی: صفحه شواهد و کیساستادیهای زنده * شروع ممیزی سازمانی: سفارش ممیزی جامع GEO و دیدهشدن در هوش مصنوعی * ارتباط و مشاوره تخصصی: تماس با تقی مولوی